مقایسه هوش مصنوعی ها در یک نگاه: کدام مدل برای چه کاری
جواب کوتاه این است: برای گفتوگوی روزمره و کارهای متنوع ChatGPT، برای فایلهای بلند و کار با اکوسیستم گوگل Gemini، برای نوشتنِ دقیق و کدنویسی Claude و برای هزینهی کم یا مدلهای متنباز DeepSeek و Qwen و Kimi انتخابهای منطقیاند. جدول زیر همین را در یک نگاه نشان میدهد؛ بخشهای بعد دلیلِ هر ردیف را باز میکنند.
| کار | انتخابِ اول | جایگزینِ خوب | چرا |
|---|---|---|---|
| نوشتنِ فارسیِ روان | Claude یا ChatGPT | Gemini | لحن طبیعیتر و کمتر ترجمهای |
| درس و حل مسئله | ChatGPT یا Gemini | DeepSeek | استدلالِ گامبهگام و توضیحِ روشن |
| برنامهنویسی | Claude یا ChatGPT | DeepSeek و Qwen | کدِ تمیز و پیدا کردنِ خطا |
| تحلیلِ عکس و نمودار | Gemini یا ChatGPT | Claude | درکِ تصویر و متنِ داخلِ عکس |
| خلاصهی فایل یا کتابِ بلند | Gemini | Claude | پنجرهی متنِ خیلی بزرگ |
| جستوجو و تحقیقِ وب | Perplexity یا Gemini | ChatGPT و Grok | منبعدهی و دسترسی به وبِ زنده |
| کارِ ارزان و حجمِ زیاد | DeepSeek و Qwen | Kimi | قیمتِ بسیار پایینتر |
نتیجهی جدول: «بهترین» بدونِ نامِ کار معنی ندارد. اگر فقط یک اشتراک میخواهید، ChatGPT یا Claude؛ اگر بیشترِ کارتان با فایل و سرویسهای گوگل است، Gemini؛ و اگر بودجه محدود است، مدلهای چینی را اول امتحان کنید. این جدول در مهر ۱۴۰۵ بازبینی شده و با هر نسخهی تازه عوض میشود.
اگر دنبالِ رتبهبندیِ کلی هستید، رتبهها هر ماه جابهجا میشوند؛ این نوشته بهجای رتبه، قابلیتها و روشِ سنجش را میدهد تا خودتان تصمیم بگیرید. برای نگاهِ سهگانهی کوتاهتر هم میتوانید مقایسهی Claude با ChatGPT و Gemini را بخوانید، و اگر هنوز با مفهومِ مدل زبانی آشنا نیستید، هوش مصنوعی چیست؟ نقطهی شروعِ خوبی است.
روشِ آزمون: ۱۰ پرامپتِ یکسانِ فارسی روی همهی مدلها
مقایسهی منصفانه یعنی یک پرامپتِ یکسان، بدونِ دستکاری، روی همهی مدلها. چیزی که از این بخش میگیرید یک آزمونِ آماده است که ۲۰ دقیقه وقت میبرد و نتیجهاش برای نیازِ خودِ شما معتبر است، نه برای میانگینِ اینترنت. ما در این نوشته نتیجهی خروجیها را به نامِ «نتیجهی قطعی» نمیآوریم، چون جوابها با هر نسخه و هر بار اجرا فرق میکند؛ بهجایش خودِ آزمون و معیارِ نمرهدادن را میدهیم.
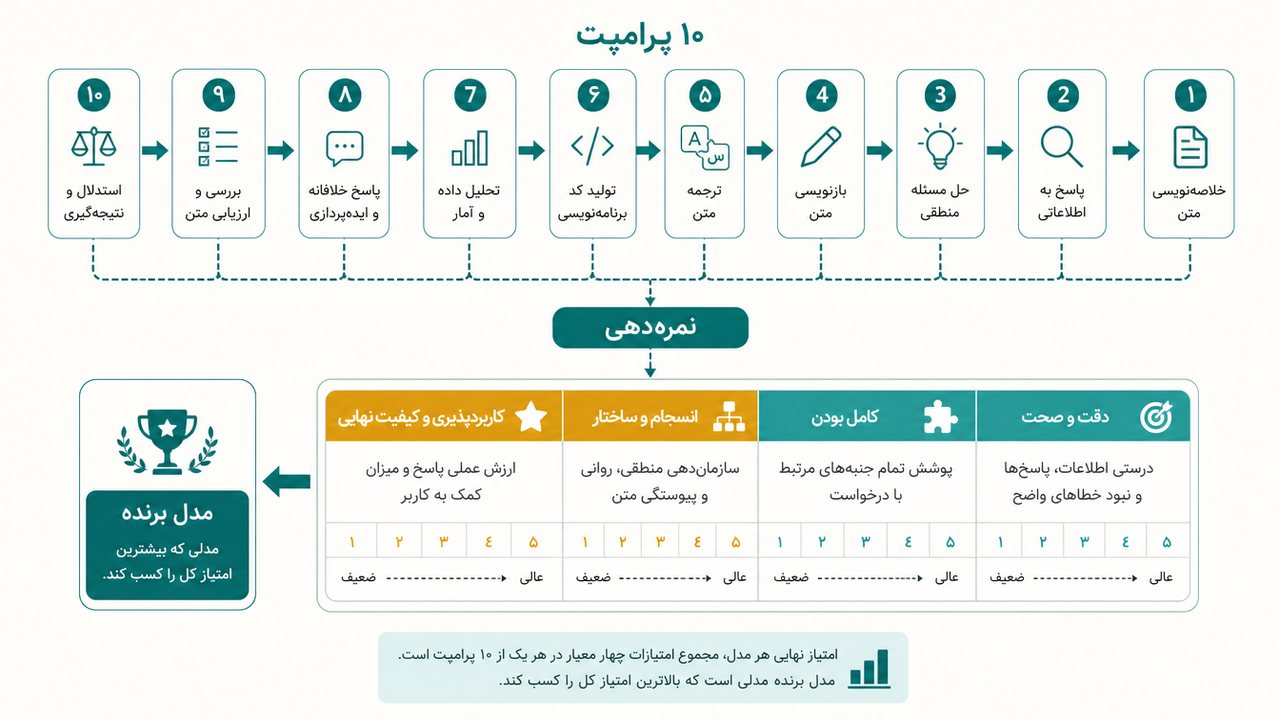
این ۱۰ پرامپت حوزههای اصلیِ کارِ یک کاربرِ فارسیزبان را میپوشانند. هر کدام را عیناً کپی کنید و در همهی مدلها بچسبانید:
- نوشتنِ رسمی: «یک نامهی رسمی و مؤدبانه بنویس برای درخواستِ مرخصیِ سهروزه از مدیرم؛ حداکثر ۱۰۰ کلمه.»
- نوشتنِ خلاق: «یک داستانِ کوتاهِ ۱۵۰ کلمهای دربارهی پیرمردی در بازارِ قدیمیِ تبریز بنویس که یک ساعتِ خراب پیدا میکند.»
- خلاصهسازی: یک متنِ ۱۰۰۰ کلمهای را بدهید و بخواهید «در ۵ جمله و با ۳ نکتهی اجرایی خلاصه کن».
- استدلالِ ریاضی: «قیمتِ یک کالا ۲۰٪ گران شد و بعد ۲۰٪ تخفیف خورد؛ قیمتِ نهایی نسبت به اول چند درصد تغییر کرده؟ گامبهگام حل کن.»
- منطق: یک معمای کوتاهِ منطقی بدهید و بخواهید «پیش از جواب، مراحلِ فکرت را بنویس».
- کدنویسی: «تابعی در Python بنویس که فهرستی از تاریخهای شمسی را بگیرد و آنها را مرتب کند؛ با توضیحِ کوتاه.»
- پیدا کردنِ خطا: یک تکه کدِ دارایِ باگ بدهید و بپرسید «مشکل کجاست و نسخهی درستش چیست؟».
- ترجمه: یک پاراگرافِ انگلیسیِ فنی را بدهید و بخواهید «به فارسیِ روان و غیرِ ترجمهای برگردان».
- تحلیلِ عکس: عکسِ یک نمودار یا فاکتور را بفرستید و بپرسید «سه نتیجهی اصلیِ این تصویر چیست؟».
- پاسخِ به سؤالِ تازه: «آخرین نسخهی مدلِ شما چیست و تا چه تاریخی اطلاعات دارید؟» تا ببینید مدل مرزِ دانشِ خودش را صادقانه میگوید یا نه.
برای نمرهدادن، هر خروجی را از ۱ تا ۵ در چهار معیار بسنجید: درستیِ محتوا، فارسیِ طبیعی (بدونِ جملهی ترجمهای)، پیروی از دستور (طول، قالب، تعدادِ نکتهها) و صادقبودن (اعتراف به ندانستن بهجای حدس). جمعِ نمرهها در یک جدولِ ساده، بهتر از هر رتبهبندیِ عمومی به شما میگوید کدام مدل را نگه دارید.
چند نکته برای آزمونِ عادلانه: هر پرامپت را در یک گفتوگوی تازه بفرستید تا حافظهی قبلی اثر نگذارد؛ هر پرامپت را دو بار اجرا کنید چون خروجیها تصادفیاند؛ و اگر مدلی «حالتِ تفکر» دارد، همه را در حالتِ مشابه بسنجید. هزینهی این آزمون با چندمدلیبودنِ پلتفرمهایی مثلِ چت با هوش مصنوعی در هوشنو پایین میآید، چون لازم نیست برای هر مدل حسابِ جدا بسازید؛ هوشنو سرویسِ خودِ ماست.
جدولِ بزرگِ مقایسه: فارسی، استدلال، کد، عکس، وب و طولِ متن
این جدول قابلیتها را بر پایهی اعلامِ سازندگان و تجربهی عمومیِ کاربران نشان میدهد، نه بر پایهی یک آزمونِ تکِ ما؛ علامتها «قوی»، «خوب» و «متوسط» هستند و با هر نسخه ممکن است عوض شوند. نامها به خانوادهی مدل اشاره دارند، چون نسخهی دقیق ماهانه تغییر میکند.
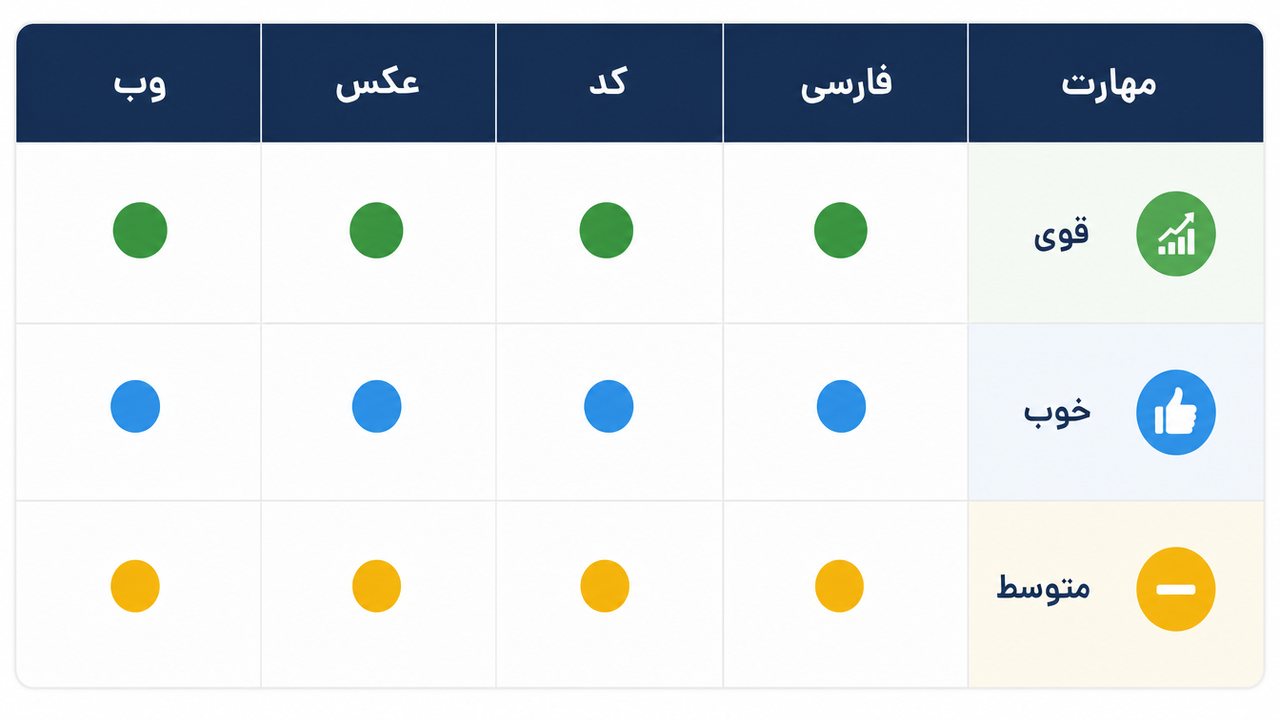
| مدل | فارسی | استدلال | کد | عکس | وب |
|---|---|---|---|---|---|
| ChatGPT | قوی | قوی | قوی | قوی | دارد |
| Gemini | قوی | قوی | خوب | قوی | قوی (گوگل) |
| Claude | قوی | قوی | قوی | خوب | دارد |
| DeepSeek | خوب | قوی | قوی | متوسط | محدود |
| Qwen | خوب | خوب | قوی | خوب | بسته به نسخه |
| Kimi | خوب | خوب | خوب | متوسط | دارد |
| Grok | خوب | خوب | خوب | خوب | قوی (شبکهی X) |
نتیجهی جدول: در فارسی و استدلال، فاصلهی سه مدلِ آمریکایی باریک است و بیشترِ تفاوتِ شما را «لحنِ نوشتن» میسازد. در کد و قیمت، مدلهای چینی خوب رقابت میکنند. در وب و عکس، سرویسهایی که به موتورِ جستوجوی خودشان وصلاند برتری دارند.
ستونِ آخرِ بسیاری از مقایسهها «طولِ متن» است، یعنی چند کلمه را یکجا میخوانند. بیشترِ مدلهای امروزی تا صدها هزار توکن را میپذیرند و بعضی تا حدودِ یک میلیون؛ برای یک کتابِ ۳۰۰ صفحهای معمولاً کافی است. ولی «پذیرفتن» با «دقیق بهخاطر سپردنِ همهی جزئیات» فرق دارد؛ در متنهای خیلی بلند، پرسشِ دقیق و ارجاعدادن به بخشِ مشخص نتیجه را بهتر میکند.
ChatGPT (سری GPT-5): نقاطِ قوت و ضعف
چت جی پی تی (ChatGPT) محصولِ OpenAI و رایجترین دستیارِ هوش مصنوعی است. نقطهی قوتش تنوع است: نوشتن، کد، تحلیلِ عکس، گفتارِ زنده، ساختِ تصویر و فایلهای دانلودی در یک برنامه. طبقِ منابعِ مهر ۱۴۰۵، خانوادهی مدلهای فعلی در سری GPT-5 است و نسخههای آن مرتب بهروز میشوند.
- قوت: همهکارهبودن، اکوسیستمِ بزرگ (افزونهها و GPTهای سفارشی)، تحلیلِ داده و فایل، حافظهی گفتوگو.
- ضعف: گاهی بیشازحد مؤدب و طولانی مینویسد؛ نسخهی رایگان سقفِ پیام دارد؛ پرداخت و دسترسی از ایران مستقیم ساده نیست.
- مناسبِ: کسی که یک ابزارِ همهمنظوره میخواهد.
اشتراکهای رسمی طبقِ سایتِ OpenAI از رایگان شروع میشود و پلنهایی مثلِ Go و Plus (حدودِ ۲۰ دلار در ماه) و Pro دارد؛ مبلغها را پیش از خرید از خودِ سایت ببینید. ماجرای محدودیتها را در محدودیتِ چت جی پی تی در نسخهی رایگان و پولی آوردهایم و راهنمای کاملِ معرفی را در چت جی پی تی چیست؟ میخوانید.
Gemini 3.x: نقاطِ قوت و ضعف
جمینای (Gemini) مدلِ گوگل است و مهمترین مزیتش اتصال به جستوجو، Gmail، Drive و YouTube و پنجرهی متنِ بسیار بزرگ است. طبقِ صفحهی رسمیِ اشتراکهای گوگل، سری Gemini 3.x فعال است و پلنِ Google AI Pro حدودِ ۱۹٫۹۹ دلار در ماه است؛ نسخهی رایگان هم با سقفِ روزانه وجود دارد.
- قوت: فایلها و ویدیوهای بلند، تحلیلِ عکس، جستوجوی تازه، یکپارچگی با سرویسهای گوگل.
- ضعف: در بعضی کارهای نوشتنیِ ظریف، متنِ یکنواختتری میدهد؛ مدلهای Pro در نسخهی رایگان محدود شدهاند؛ پرداختِ ارزی لازم است.
- مناسبِ: دانشجو، پژوهشگر و کسی که مدام با فایل و PDF کار میکند.
برای گرفتنِ بهترین نتیجه از این مدل، راهنمای پرامپتنویسی اصولی در Gemini را ببینید.
Claude (خانوادهی Opus و Sonnet): نقاطِ قوت و ضعف
کلود (Claude) محصولِ Anthropic است و بیشتر برای نوشتنِ دقیق، تحلیلِ متنهای بلند و کدنویسی شناخته میشود. طبقِ اعلامِ سازنده، مدلها در سه ردهی Opus (قویترین)، Sonnet (متعادل) و Haiku (سریع و ارزان) عرضه میشوند و اشتراکِ Claude Pro حدودِ ۲۰ دلار در ماه است.
- قوت: لحنِ طبیعیتر در نوشتن، پیروی دقیق از دستور، کدِ تمیز و توضیحِ خوبِ خطاها، پاسخِ صادقانهتر به «نمیدانم».
- ضعف: ابزارهای جانبیِ کمتری نسبت به ChatGPT؛ ساختِ تصویر ندارد؛ سقفِ پیامِ پلنِ رایگان زود پر میشود.
- مناسبِ: نویسنده، برنامهنویس و کسی که خروجیِ تمیز و بدونِ حاشیه میخواهد.
برای شروعِ فارسیاش استفاده از Claude به زبان فارسی و برای نوشتنِ پرامپتِ بهتر راهنمای پرامپتنویسی در Claude به کار میآید.
DeepSeek، Qwen و Kimi: مدلهای چینیِ ارزان و قوی
دیپ سیک (DeepSeek)، Qwen (علیبابا) و Kimi (Moonshot) نشان دادهاند که مدلِ قوی لزوماً گران نیست؛ هزینهی APIشان معمولاً چند برابر پایینتر از رقبای آمریکایی است و بخشی از آنها با وزنِ باز عرضه میشود. نسخهها سریع عوض میشوند، پس شماره را از صفحهی رسمیِ هر مدل ببینید.
- DeepSeek: استدلال و کدنویسیِ قوی با قیمتِ پایین؛ گاهی سرور شلوغ است. دیپ سیک چیست؟ و علتِ کار نکردنِ دیپ سیک را ببینید.
- Qwen: خانوادهی بزرگی از مدلهای متنی، کدنویسی و تصویری؛ چندزبانه و در کد قوی.
- Kimi: تمرکز بر متنهای بلند و کارهای چندمرحلهای (ایجنت).
محدودیتِ مشترک: فارسیِ این مدلها خوب است ولی هنوز در لحنِ نوشتن گاهی «ترجمهای» به نظر میرسد؛ و دربارهی حریمِ خصوصی، قوانینِ ذخیرهی داده در هر سرویس متفاوت است، پس اطلاعاتِ حساس را به هیچکدام ندهید. معرفیِ گستردهتر در هوش مصنوعی چینی آمده است.
Grok، Copilot و Perplexity: کِی به کار میآیند
این سه ابزار جای مدلهای اصلی را نمیگیرند، ولی در سناریوهای مشخص بهتر از بقیهاند. Grok (xAI) به شبکهی X وصل است و برای دنبال کردنِ موضوعاتِ لحظهای مناسب است؛ معرفیِ کاملِ Grok را ببینید. Copilot (مایکروسافت) در Word، Excel و ویندوز نشسته و برای کارِ اداری راحت است. Perplexity برای تحقیق ساخته شده و هر پاسخ را با منبع میدهد.
| ابزار | بهترین کاربرد | محدودیت |
|---|---|---|
| Grok | موضوعهای لحظهای و گفتوگوی غیررسمی | کیفیتِ فارسی و ثباتِ نتیجه متغیر |
| Copilot | کارِ اداری در Office و ویندوز | بدونِ اشتراک و حسابِ مایکروسافت محدود است |
| Perplexity | تحقیق با منبع و جستوجوی وب | برای نوشتنِ خلاقانه ساخته نشده |
نتیجهی جدول: اگر هدفتان «پیدا کردنِ منبعِ معتبر» است، Perplexity؛ اگر کارتان در Office است، Copilot؛ و برای باقیِ کارها همان مدلهای اصلی کافیاند.
قیمت و محدودیتِ نسخهی رایگان
همهی سرویسهای بزرگ یک نسخهی رایگان با سقفِ روزانه و یک اشتراکِ حدودِ ۲۰ دلاری در ماه دارند. قیمتها زیر دلاری و بر پایهی صفحههای رسمی در مهر ۱۴۰۵ نوشته شدهاند؛ ما آنها را به تومان تبدیل نمیکنیم، چون نرخِ ارز هر روز تغییر میکند و هر عددِ تومانیِ ثابت زود کهنه میشود.
| سرویس | رایگان | اشتراکِ معمول (دلار در ماه) | نکته |
|---|---|---|---|
| ChatGPT | دارد، با سقفِ پیام | Go و Plus حدودِ ۲۰؛ Pro گرانتر | اشتراک جدا از API است |
| Gemini | دارد، با سقفِ روزانه | AI Pro حدودِ ۱۹٫۹۹ | مدلهای Pro در رایگان محدودند |
| Claude | دارد، سقفِ کم | Pro حدودِ ۲۰؛ Max گرانتر | پلنِ سالانه ارزانتر است |
| DeepSeek | بله، رایگان | اشتراکِ معمولی ندارد؛ API ارزان | گاهی شلوغ است |
| Qwen و Kimi | بله، رایگان | API ارزان | بسته به نسخه فرق میکند |
نتیجهی جدول: برای شروع هیچجا اشتراک لازم نیست. اگر رایگانها کم آوردند، ابتدا بسنجید واقعاً به همهی مدلها نیاز دارید یا فقط به یکی. هزینهی چند اشتراکِ همزمان زود از یک پلتفرمِ چندمدلی بیشتر میشود.
برای کاربرِ ایرانی، یک مانعِ عملی هم هست: بعضی سرویسها مستقیم در دسترس نیستند یا پرداختِ ارزی میخواهند. راهِ قانونی و ساده این است که از همان مدلها در یک پلتفرمِ داخلی با پرداختِ تومانی استفاده کنید؛ «هوش مصنوعی آنلاین فارسی» مثلِ هوشنو همین کار را با پرداختِ اعتباریِ بدونِ اشتراکِ اجباری انجام میدهد؛ هزینهی هر ساخت پیش از شروع در خودِ ابزار نشان داده میشود.
مقایسههای دوبهدو و راهنماهای مرتبط
اگر دو مدلِ مشخص را در نظر دارید، این نوشتهها را ببینید. مقایسههای دوبهدوی دیگر (ChatGPT با Gemini، Claude با ChatGPT، DeepSeek با ChatGPT و …) بهتدریج منتشر میشوند و از همین صفحه به آنها لینک خواهیم داد.
- مقایسهی Claude با ChatGPT و Gemini: نگاهِ سهگانه با مزایا و معایب.
- مقایسهی مدلهای ساختِ عکس و ویدیو: برای وقتی دنبالِ تصویر و ویدیو هستید.
- هوش مصنوعیهای جدیدِ این ماه: فهرستِ بهروزِ مدلهای تازه.
- سایتهای چتِ رایگانِ هوش مصنوعی: جایگزینهای رایگان.
- پلتفرمهای هوش مصنوعیِ فارسی: انتخاب با پرداختِ تومانی.
- پرسش از هوش مصنوعی آنلاین و رایگان: کمدردسرترین راهها.
کدام مدل برای چه کسی: پنج سناریوی واقعی
بهجای پرسیدنِ «کدام بهتر است»، از خودتان بپرسید «من چه کاری را بیشتر انجام میدهم». پنج سناریوی رایج و انتخابِ پیشنهادی برای هر کدام اینهاست؛ همه بر پایهی ویژگیهای اعلامشدهی سازندگان و تجربهی عمومی کاربراناند و اگر نتیجهی آزمونِ خودتان فرق داشت، به آزمون اعتماد کنید.
دانشجو و دانشآموز
برای فهمیدنِ درس، حل مسئلهی گامبهگام و ساختنِ نمونهسؤال، ChatGPT و Gemini انتخابهای راحتیاند؛ هر دو توضیح را ساده میکنند و عکسِ سؤال را میخوانند. اگر فایلِ جزوهی بلند دارید، Gemini پنجرهی بزرگتری را راحتتر میپذیرد. یادتان باشد مدل را جایگزینِ فکر کردن نکنید؛ از آن بخواهید «چرا» را توضیح دهد و بعد خودتان حل کنید.
نویسنده و تولیدکنندهی محتوا
اگر فارسیِ روان و لحنِ طبیعی مهم است، Claude و ChatGPT را با یک پرامپتِ یکسان آزمایش کنید. بهترین روش این است که لحن، مخاطب و طولِ دلخواه را صریح بنویسید و یک نمونهی متنِ خودتان را برای تقلیدِ سبک بدهید. برای راهنمای بیشتر استفاده از هوش مصنوعی برای تولید محتوا را ببینید.
برنامهنویس
برای نوشتنِ تابع، بازنویسیِ کد و پیدا کردنِ باگ، Claude و ChatGPT معمولاً انتخابِ اولاند و DeepSeek و Qwen جایگزینهای ارزان و جدی. نکتهی عملی: کدِ خروجی را همیشه اجرا و تست کنید و خطای واقعی را دوباره به مدل بدهید؛ این حلقهی «اجرا، خطا، اصلاح» از هر مقایسهای مفیدتر است.
صاحبِ کسبوکار کوچک
برای نوشتنِ توضیحِ محصول، پاسخ به مشتری و ایدهی محتوا، یک مدلِ همهمنظوره کافی است. هزینه را با تعدادِ دفعاتِ استفاده بسنجید؛ اگر هر روز چند ده بار میپرسید، پرداختِ اعتباری و به اندازهی مصرف معمولاً از چند اشتراکِ ماهانه بهصرفهتر است. مثلِ تولید محتوای فارسی با هوش مصنوعی را هم ببینید.
پژوهشگر و تحلیلگر
برای تحقیقِ همراه با منبع، Perplexity و Gemini به وبِ زنده وصلاند. ولی هر عدد و نقلقولی که مدل میدهد باید با منبعِ اصلی تطبیق داده شود؛ مدلها گاهی آدرس یا آمارِ ساختگی تولید میکنند و این خطا (توهم) در همهی آنها وجود دارد.
اشتباههای رایج در مقایسهی هوش مصنوعیها
بیشترِ مقایسههای اینترنتی از چند خطای تکراری رنج میبرند. اگر اینها را بشناسید، هم مقالهها را بهتر میخوانید و هم آزمونِ خودتان را درستتر میچینید.
- مقایسهی نسخههای ناهمتراز: نسخهی رایگانِ یک مدل را با نسخهی پولیِ مدلِ دیگر سنجیدن نتیجهی بیمعنی میدهد. همیشه نسخهی همردیف را مقایسه کنید.
- یک بار پرسیدن: خروجیِ مدلها تصادفی است و یک اجرا کافی نیست. هر پرامپت را حداقل دو بار بفرستید.
- پرامپتِ متفاوت برای هر مدل: اگر برای یکی توضیحِ بیشتر بدهید، آزمون ناعادلانه میشود.
- اعتماد به بنچمارکها بهتنهایی: عددِ بنچمارک نشان میدهد مدل در آزمونی خاص چطور بوده، نه در کارِ روزمرهی شما.
- نادیده گرفتنِ هزینه و سقف: مدلِ بسیار قوی که پس از چند پیام قفل میشود، برای کارِ حجیم مناسب نیست.
- فراموشکردنِ تاریخ: هر جدول فقط تا زمانِ نوشتنش درست است؛ تاریخِ بازبینی را بخوانید.
اگر میخواهید بنچمارکها را بهتر بفهمید، بهزودی یک راهنمای جدا دربارهی آنها منتشر میشود؛ تا آن موقع قاعدهی ساده این است که نتیجهی بنچمارک را یک سرنخ بدانید، نه حکمِ نهایی.
حریم خصوصی و امنیت: چه چیزهایی را به مدلها ندهیم
هر مدلی که از آن استفاده میکنید ممکن است متنِ گفتوگو را روی سرورهایش نگه دارد و، بسته به تنظیمات، برای بهبودِ مدل به کار ببرد. قانونها و تنظیماتِ هر سرویس فرق دارد و در صفحهی حریمِ خصوصیِ همان سرویس نوشته شده است؛ پس پیش از ارسالِ هر چیزِ حساس، آن را بخوانید.
- رمزها، کلیدهای API، شمارهی کارت و اطلاعاتِ بانکی را هرگز در چت ننویسید.
- قراردادها و فایلهای محرمانهی کارفرما را بدونِ اجازه نفرستید؛ اگر لازم است، نامها و اعداد را حذف کنید.
- برای موضوعهای پزشکی و حقوقی، پاسخِ مدل راهنمای اولیه است و جایگزینِ پزشک یا وکیل نیست.
- اگر مدلی «حافظه» دارد، بدانید چه چیزی را بهخاطر میسپارد و در تنظیمات میتوانید پاکش کنید.
دربارهی مدلهای چینی و متنباز هم همین قاعده برقرار است؛ ضمناً مدلِ متنباز را اگر روی سیستمِ خودتان اجرا کنید، داده از دستگاهتان بیرون نمیرود، ولی به سختافزارِ قوی نیاز دارد.
چطور از هر مدل نتیجهی بهتر بگیریم: قالبِ پرامپتِ یکسان
حتی بهترین مدل با پرامپتِ مبهم نتیجهی معمولی میدهد. یک قالبِ ساده که روی همهی مدلها جواب میدهد این است:
نقش: تو یک ویراستارِ باتجربهی فارسی هستی. کار: متنِ زیر را برای مخاطبِ عمومی بازنویسی کن. قالب: در ۳ بند و بدونِ اصطلاحِ فنی. محدودیت: حداکثر ۱۵۰ کلمه و بدونِ جملهی ترجمهای. متن: [متن را اینجا بگذارید]
چهار جزءِ نقش، کار، قالب و محدودیت، خروجی را قابلپیشبینی میکنند. اگر نتیجه خوب نبود، بهجای تکرارِ همان پرامپت، یک خطِ اصلاحی بدهید («کوتاهتر کن و لحنِ رسمیتر باش»). برای آموزشِ عمیقتر راهنمای پرامپتِ چت جی پی تی و پرامپتنویسی در DeepSeek را بخوانید؛ اصولشان در بیشترِ مدلها یکی است.
تفاوتِ مدلهای بسته و متنباز در انتخاب
مدلهای بسته (ChatGPT، Gemini، Claude) فقط از طریقِ سرویسِ سازنده در دسترساند. مدلهای متنباز یا «وزنباز» مثلِ بعضی نسخههای DeepSeek، Qwen و Kimi را میشود دانلود و روی سرورِ خودتان اجرا کرد. این تفاوت روی سه چیز اثر میگذارد: هزینه، کنترل و کیفیتِ بالاترین رده.
| معیار | مدلِ بسته | مدلِ متنباز |
|---|---|---|
| کیفیتِ بالاترین رده | معمولاً کمی جلوتر | بسیار نزدیک و در بعضی کارها برابر |
| هزینه | اشتراک یا API گرانتر | API ارزانتر؛ اجرای محلی نیازمندِ سختافزار |
| کنترل و حریم خصوصی | داده در سرورِ سازنده | امکانِ اجرا روی سرورِ خودتان |
| سهولتِ شروع | ساده، فقط یک حساب | برای اجرای محلی فنیتر است |
نتیجهی جدول: کاربرِ عادی به مدلِ بسته یا به یک سرویسِ آمادهی چندمدلی نیاز دارد؛ تیمِ فنی و شرکتهایی که به کنترلِ داده اهمیت میدهند، مدلِ متنباز را جدی بگیرند. اگر تصمیم نگرفتهاید، با یک سرویسِ آماده شروع کنید و بعداً اگر هزینه یا حریمِ خصوصی مهم شد، به متنباز بروید.
یک نکتهی پایانی: «بهترینِ امروز» دوامِ زیادی ندارد. هر چند هفته یک نسخهی تازه میآید و ترتیب را عوض میکند. به همین دلیل بهتر است بهجای وفاداری به یک برند، عادتِ سنجیدنِ سریعِ مدلها با همان ۱۰ پرامپتِ ثابت را داشته باشید و هر چند ماه یک بار آزمون را تکرار کنید. این عادت کمتر از یک ساعت زمان میبرد و از پرداختِ بیدلیل برای اشتراکی که دیگر مناسبِ شما نیست جلوگیری میکند.
چطور خودتان همهی مدلها را کنارِ هم امتحان کنید
سریعترین راه، اجرای همان ۱۰ پرامپتِ بخشِ آزمون در یک پلتفرمِ چندمدلی است. این گامها را در هوشنو دنبال کنید:
- وارد صفحهی چت با هوش مصنوعی به فارسی شوید و شمارهی موبایلتان را تأیید کنید؛ چتِ رایگانِ روزانه فعال میشود.
- از منوی انتخابِ مدل، یکی از مدلهای موجود (مثلِ GPT، Claude، Gemini یا DeepSeek) را انتخاب کنید.
- پرامپتِ اول را کپی و ارسال کنید و خروجی را در یک فایلِ یادداشت ذخیره کنید.
- مدل را عوض کنید و همان پرامپت را در گفتوگوی تازه دوباره بفرستید.
- پس از ۱۰ پرامپت، جدولِ نمرهها را بسازید و مدلِ برنده برای هر کار را مشخص کنید.
همین الان امتحان کنید: یک پرامپتِ ریاضی و یک پرامپتِ نوشتن را روی دو مدلِ متفاوت در چتِ هوشنو بفرستید و تفاوتِ لحن و دقت را خودتان ببینید. هوشنو امکاناتِ دیگری هم دارد، مثلِ ساخت عکس و ویدیو، ولی برای این آزمون همان چت کافی است.
سؤالات متداول
کدام هوش مصنوعی بهتر است؛ ChatGPT یا Gemini یا Claude؟
جوابِ یکسان برای همه وجود ندارد. ChatGPT همهکارهتر است، Gemini برای فایلهای بلند و سرویسهای گوگل راحتتر است و Claude در نوشتنِ دقیق و کد معمولاً نتیجهی تمیزتری میدهد. بهترین راه اجرای یک پرامپتِ یکسان روی هر سه و مقایسهی خروجیها است.
بهترین هوش مصنوعی برای فارسی کدام است؟
در بیشترِ تجربهها Claude و ChatGPT فارسیِ طبیعیتری مینویسند و Gemini هم نزدیک است. DeepSeek و Qwen فارسی را میفهمند ولی گاهی ترجمهای مینویسند. چون نسخهها عوض میشوند، با پرامپتِ نامهی رسمی و ترجمهی فنی خودتان آزمایش کنید.
کدام هوش مصنوعی رایگان قویتر است؟
در نسخهی رایگان، DeepSeek و Qwen معمولاً سقفِ سخاوتمندانهتری دارند، ولی ChatGPT و Gemini هم برای کارهای روزمره کافیاند. سقفها و مدلِ در دسترس مرتب عوض میشوند؛ صفحهی رسمیِ هر سرویس را بخوانید.
تفاوتِ مدلهای هوش مصنوعی در چیست؟
تفاوتها در دادهٔ آموزش، اندازهی مدل، پنجرهی متن، سرعت، قیمت و ابزارهای جانبی (وب، عکس، فایل) است. دو مدل ممکن است یک سؤال را درست جواب بدهند ولی در لحن، طولِ پاسخ و دقت در جزئیات فرق کنند؛ برای همین باید با کارِ خودتان سنجید.
آیا میشود چند هوش مصنوعی را در یک جا مقایسه کرد؟
بله، پلتفرمهای چندمدلی این کار را ممکن میکنند و لازم نیست برای هر مدل حساب بسازید. در هوشنو میتوانید در همان صفحهی چت مدل را عوض کنید و یک پرامپت را روی چند مدل بفرستید. هوشنو سرویسِ خودِ ماست.
چقدر میشود به نتیجهی مقایسهها اعتماد کرد؟
بهشرطی که تاریخ و روشِ آزمون را بگویند. جدولهای بیتاریخ زود کهنه میشوند، چون نسخهها هر چند هفته عوض میشوند. اعتمادِ بیشتر یعنی آزمونِ کوتاه با ۱۰ پرامپتِ خودتان.
جمعبندی
هیچ مدلی در همهی کارها برنده نیست: ChatGPT برای تنوع، Gemini برای فایل و وب، Claude برای نوشتن و کد، و DeepSeek و Qwen و Kimi برای هزینهی کم انتخابهای جدیاند. چیزی که تصمیم را آسان میکند آزمونِ کوتاهِ خودِ شماست، نه رتبهبندیِ کلی. قدمِ بعدی را ساده بردارید: ۱۰ پرامپتِ بالا را روی دو یا سه مدل بفرستید و برای هر کار یک مدلِ اصلی انتخاب کنید.
این جدولها هر ماه بازبینی میشوند؛ آخرین بررسی مهر ۱۴۰۵. اگر خروجیِ شما با جدولِ ما فرق داشت، به آزمونِ خودتان اعتماد کنید و برای ساختِ عکس و ویدیو هم مقایسهی مدلهای تصویر و ویدیو را ببینید.