مقایسه هوش مصنوعیهای ساخت عکس و ویدیو یک جواب ساده دارد: برندهی مطلق وجود ندارد و هر مدل در یک کار جلوتر است. برای متن روی عکس و دقتِ پرامپت معمولاً GPT Image، برای زیبایی هنری Midjourney، برای ویرایش و ثبات Nano Banana Pro، و برای ویدیو بسته به نیاز Veo، Kling یا Seedance انتخاب خوبیاند. این نوشته آخرین بار در مهر ۱۴۰۵ بازبینی شده است.
اگر فقط فهرستِ ابزارها را میخواهید، به فهرست ابزارهای تصویرساز و راهنمای ابزارهای ساخت ویدیو سر بزنید. اینجا کار دیگری میکنیم: مدلها را با یک مجموعه پرامپتِ یکسان کنار هم میگذاریم و میگوییم هر کدام کجا میدرخشد و کجا میلنگد.
همین الان امتحان کنید: بیشتر مدلهای این مقاله را میتوانید در ساخت ویدیو با هوش مصنوعی در هوشنو و ساخت عکس در هوشنو با پرداخت تومانی، بدون اشتراک اجباری و بدون حساب خارجی امتحان کنید. هوشنو سرویس خودِ ماست.
مقایسه هوش مصنوعیهای ساخت عکس و ویدیو: جواب کوتاه
اگر عجله دارید، این جدول انتخابِ سریع است. این جمعبندی بر پایهی مقایسههای عمومیِ منتشرشده در ماههای اخیر و امکاناتِ اعلامشدهی سازندگان نوشته شده و خروجیِ هر مدل با هر پرامپت ممکن است فرق کند.
| کار شما | انتخاب اول | انتخاب دوم |
|---|---|---|
| پوستر و عکسی که متن دارد | GPT Image | Nano Banana Pro |
| عکس محصول و ویرایش عکس موجود | Nano Banana Pro | GPT Image |
| تصویر هنری و مفهومی با حالِوهوای سینمایی | Midjourney | Flux |
| کنترل دقیق و تولید انبوه | Flux | Qwen Image |
| ویدیوی واقعگرا با صدا | Veo 3.1 | Seedance |
| حرکت و دوربینِ نرم، ویدیوی تبلیغاتی | Kling | Veo 3.1 |
| ویدیویی که آدم حرف میزند و لبها هماهنگ است | Seedance | Veo 3.1 |
| ویدیوی کوتاه و ارزان برای تست ایده | Pixverse | Minimax |
نتیجهی جدول: انتخابِ مدل را به نوعِ خروجی ببندید، نه به شهرتِ نام. برای یک کار میتوانید دو مدل را امتحان کنید و ارزانترینی را که کافی است نگه دارید.
روش آزمون: ۸ پرامپت عکس و ۶ پرامپت ویدیو
مقایسهی منصفانه یعنی پرامپت یکسان، تنظیماتِ یکسان و چند بار تکرار. یک خروجیِ خوب یا بد معنیدار نیست، چون هر مدل گاهی شانسی خوب میشود. این روشی است که پیشنهاد میکنیم و میتوانید خودتان دقیقاً تکرارش کنید.
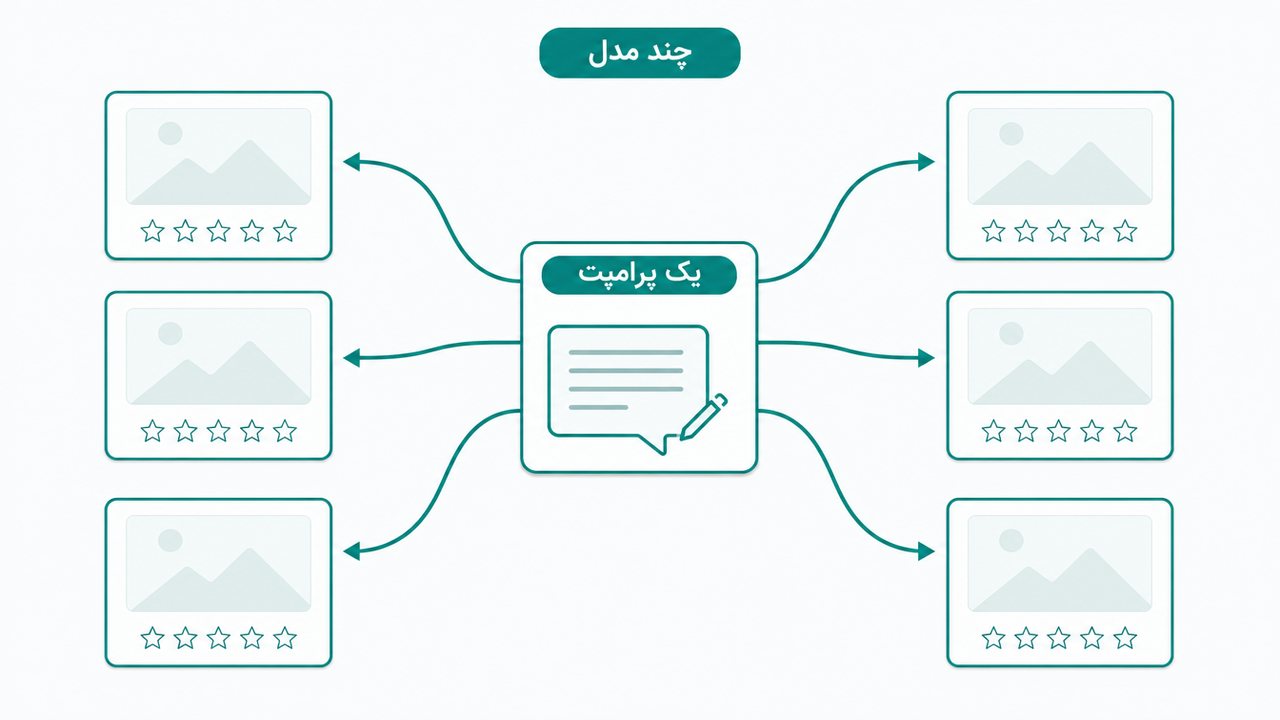
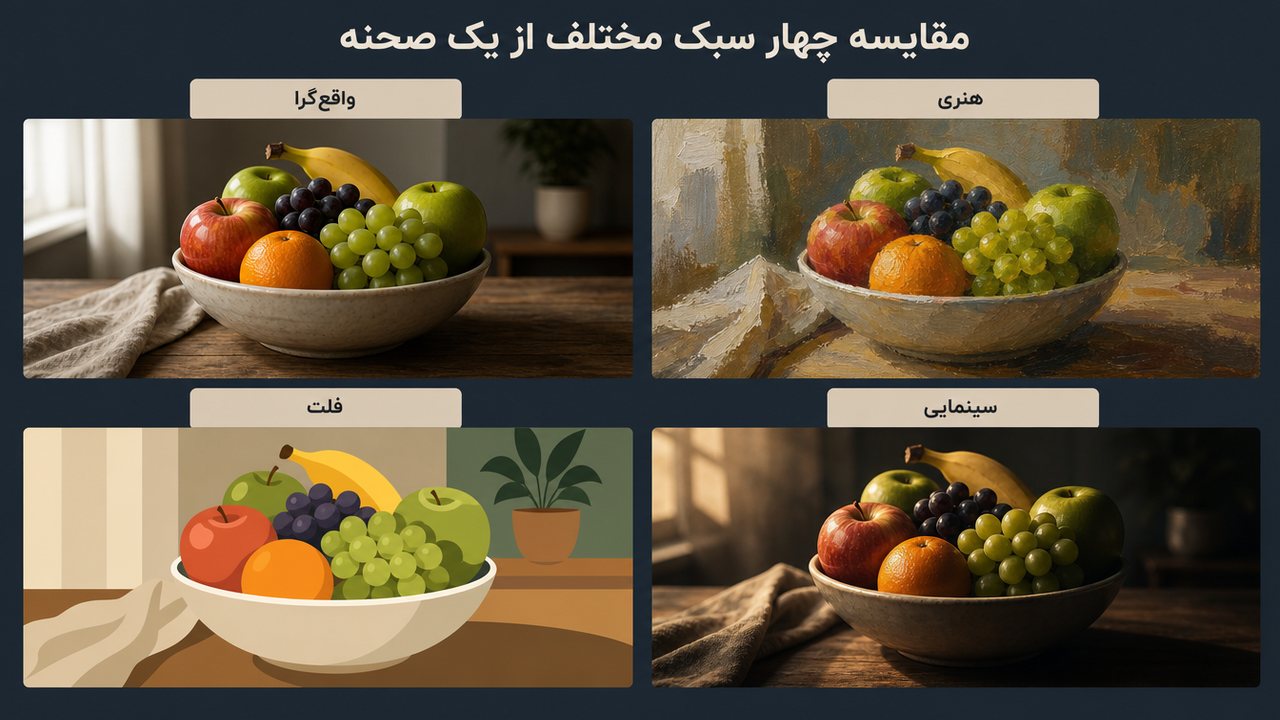
هشت پرامپتِ عکس باید چند مهارت را جدا بسنجند: واقعگرایی، دست و انگشت، متن فارسی، متن انگلیسی، پیروی از جزئیات، ویرایش عکس، سبک هنری و ترکیببندیِ شلوغ. نمونهها:
- پرتره: پرترهی نیمتنهی یک پیرمردِ خیالی در بازار سنتی، نور نرمِ عصر.
- دست و شیء: دستی که فنجانِ چای را روی میز چوبی میگیرد، نمای نزدیک.
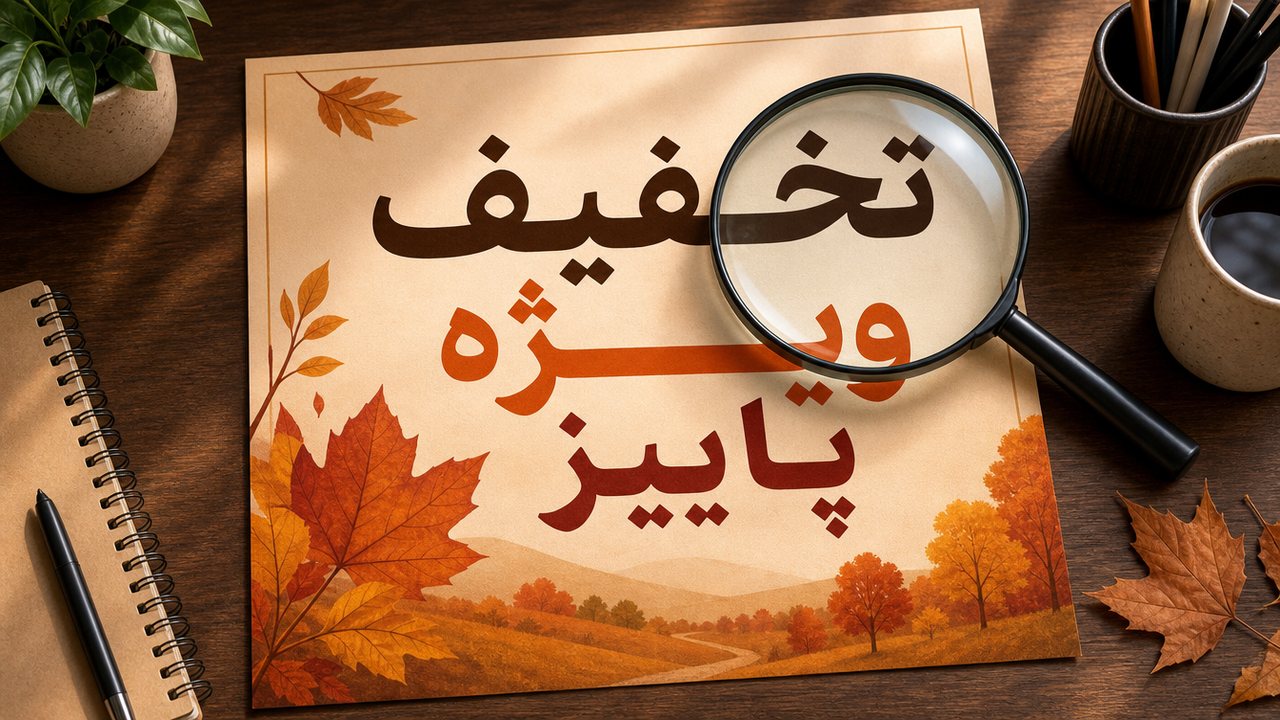
- متن فارسی: بنری با عبارت «تخفیف ویژه پاییز» به خط خوانا.
- متن انگلیسی: تابلوی کافه با عبارت «Open Daily» و منو.
- جزئیات پرامپت: سه سیب قرمز و دو پرتقال روی دستمالِ آبی، گلدانِ سمتِ چپ.
- ویرایش: عکسی را بدهید و بخواهید پسزمینه عوض شود و سوژه ثابت بماند.
- سبک هنری: تصویرسازیِ آبرنگ از یک شهرِ کویری.
- صحنهی شلوغ: میدانی پر از آدمهای عمومی با چراغهای شب.
شش پرامپتِ ویدیو هم همینطور: حرکتِ دوربین، فیزیک، آدمی که حرف میزند، تبدیلِ عکس به ویدیو، صحنهی چندنفره و ثباتِ چهره. نمونهی یکی از آنها:
A slow dolly-in shot of a saffron seller arranging jars in a sunlit Persian bazaar, warm light, shallow depth of field, gentle ambient market sound, 8 seconds.
برای هر نتیجه چهار معیار را از ۱ تا ۵ نمره بدهید: دقت در پیروی از پرامپت، کیفیتِ بصری، ثبات (دست، چهره، متن) و هزینهی هر خروجیِ قابلقبول. معیار آخر را فراموش نکنید؛ مدلی که سه بار تکرار میخواهد ممکن است از مدلِ گرانترِ یکباره ارزانتر تمام نشود. برای نوشتنِ بهتر پرامپت، آموزش پرامپتنویسی برای ساخت تصویر را ببینید.
مدلهای ساخت عکس: Nano Banana Pro، GPT Image، Midjourney، Flux و Qwen Image
پنج مدلِ پرکاربرد عکس را اینجا کنار هم میگذاریم. نظرها خلاصهی عمومیِ مقایسههای ماههای اخیر و مستنداتِ سازندگان است، نه آزمونِ اختصاصیِ ما.
Nano Banana Pro
مدل تصویرِ گوگل است و در ویرایشِ عکس، حفظِ ثباتِ سوژه بین چند تصویر و خروجیِ با وضوحِ بالا شهرت دارد. برای عکسِ محصول و ساخت چند نسخه از یک شخصیتِ خیالی گزینهی خوبی است. ضعفِ احتمالیاش در متنِ بسیار شلوغ است.
GPT Image
مدل تصویرِ OpenAI است که در پیروی از جزئیاتِ پرامپت و نوشتنِ متن روی تصویر معمولاً بهترینها را دارد. اگر پوستر یا بنرِ متنی میخواهید، اول از این شروع کنید. هزینهی هر تصویر در مقایسهها معمولاً بالاتر از بعضی رقبا گزارش میشود.
Midjourney
قویترین مدل برای حالِوهوا، رنگ و ترکیببندیِ هنری است. برای تصویرسازی، مفهومسازی و ایدهپردازی عالی است، ولی در پیروی دقیق از جزئیات و متن معمولاً از GPT Image عقبتر ارزیابی میشود. راهنمای آموزش Midjourney و پرامپتنویسی Midjourney کمک میکند.
Flux
خانوادهی مدلهای Black Forest Labs که انعطاف و کنترل دارد و برای تولیدِ انبوه مناسب است. اگر پرامپتِ دقیق مینویسید و میخواهید خروجی ارزان و سریع باشد، Flux گزینهای جدی است. پرامپتنویسی Flux را ببینید.
Qwen Image
مدلِ تصویرِ علیبابا است و بهخاطر درکِ متن در تصویر و باز بودنِ بخشی از خانوادهاش مورد توجه است. برای کارهای متنی و چندزبانه ارزش امتحان دارد.
نتیجهی این بخش: برای کارِ روزمره دو مدل کافی است؛ یکی برای دقت و متن (GPT Image) و یکی برای زیبایی (Midjourney) یا ویرایش (Nano Banana Pro). همهی این پنج مدل را میتوانید در ابزار ساخت عکس هوشنو یکجا امتحان کنید.
متن فارسی روی عکس: کدام مدل بهتر مینویسد؟
متن فارسی هنوز سختترین آزمون است، چون حروف باید بههم وصل شوند و جهت راستبهچپ حفظ شود. در عمل مدلهایی که متنِ انگلیسی را خوب مینویسند معمولاً در فارسی هم بهتر عمل میکنند، ولی هیچ مدلی همیشه بیخطا نیست و جملهی کوتاه خیلی بهتر از جملهی بلند درمیآید.
این قاعدهها نتیجه را بهتر میکنند:
- متن را در گیومه و عیناً در پرامپت بنویسید و بگویید right-to-left Persian text, connected letters.
- متن را کوتاه نگه دارید؛ دو تا پنج کلمه.
- اگر خطای حرف دیدید، دوباره بسازید یا فقط متن را جداگانه در یک ویرایشگر اضافه کنید.
- برای متنِ مهمِ تبلیغاتی، همیشه خروجی را حرفبهحرف بخوانید.
- برای متنهای بلند، تصویر را بدونِ متن بسازید و متن را با یک ابزار طراحی روی آن بگذارید.
برای مثال کاملتر و پرامپتهای فارسی به راهنمای ساخت عکس با هوش مصنوعی فارسی مراجعه کنید. تا زمانی که خودتان روی پرامپتِ خودتان آزمون نگرفتهاید، به ادعای «بینقص» برای فارسی اعتماد نکنید.
مدلهای ساخت ویدیو: Veo، Kling، Seedance، Minimax، Pixverse و Grok Imagine
بازارِ ویدیو سریعتر از عکس عوض میشود. در زمانِ نوشتن، Veo 3.1 گوگل، Kling 3.0 و Seedance 2.0 جزو مدلهای اصلی هستند و Sora 2 هم در مقایسههای عمومی مطرح است. مشخصاتِ دقیق را همیشه از صفحهی رسمیِ سازنده بگیرید.
Veo 3.1
مدلِ ویدیوی گوگل که در واقعگرایی، درکِ پرامپت و تولیدِ ویدیو همراه با صدا شناخته میشود. برای صحنههای سینمایی و تبلیغاتیِ واقعگرا انتخابِ اول بسیاری است. راهنمای ساخت ویدیو با Veo و پرامپتنویسی Veo را ببینید.
Kling
محصولِ کوآیشو که در حرکتِ نرم، دوربینِ روان و کار با تصویرِ ورودی خوب است. برای تبدیل عکس به ویدیو و ویدیوی تبلیغاتیِ کوتاه پرطرفدار است. آموزش Kling را بخوانید.
Seedance
مدل بایتدنس که در هماهنگیِ حرکتِ لب با گفتار و صحنههای چندنفره مورد توجه است. برای ویدیوی آدممحور و گفتوگو مناسب است.
Minimax، Pixverse و Grok Imagine
این سه برای ایدهآزمایی سریع و ویدیوی کوتاه جذاباند: Minimax در حرکت، Pixverse در افکتِ آماده و سرعت، و Grok Imagine در ساخت سریع از متن و عکس. معمولاً برای تست یک ایده بهتر است اول با اینها شروع کنید و بعد نسخهی نهایی را در مدلی قویتر بسازید.
مقایسهی عمیقتر دو و سهگانهها در مقایسه Veo با رقبا و مقایسه Kling با Sora و Runway آمده است.
صدا، حرکت، ثبات چهره و طول ویدیو
چهار ویژگی تعیین میکنند یک ویدیو واقعاً قابلاستفاده است یا فقط دموی جذاب. جدول زیر برداشتِ کلیِ مقایسههای عمومی را نشان میدهد؛ بهازای هر نسخه ممکن است عوض شود.
| مدل | صدای همراه | حرکت و دوربین | ثبات چهره | طول معمولِ هر ویدیو |
|---|---|---|---|---|
| Veo 3.1 | بله، همراه ویدیو | خوب | خوب | چند ثانیه، حدود ۸ ثانیه |
| Kling | بسته به نسخه | بسیار روان | خوب با عکس ورودی | چند ثانیه تا ۱۰ ثانیه |
| Seedance | بله، با تمرکز بر لب | خوب | خوب | چند ثانیه |
| Minimax | بسته به نسخه | خوب | متوسط تا خوب | چند ثانیه |
| Pixverse | محدود | متوسط تا خوب | متوسط | چند ثانیه |
| Grok Imagine | بسته به نسخه | متوسط تا خوب | متوسط | چند ثانیه |
نتیجهی جدول: طولِ هر کلیپ در همهی مدلها کوتاه است. برای ویدیوی بلندتر چند کلیپِ کوتاه میسازند و بعد کنار هم میگذارند؛ ثباتِ چهره را هم با عکسِ ورودی یکسان و توضیحِ ثابتِ ظاهر شخصیت حفظ کنید. اگر زندهکردنِ یک عکس مدنظر است، تبدیل عکس به ویدیو را ببینید.
هزینه هر عکس و هر ثانیه ویدیو
قیمتِ دلاریِ سازندگان در ماههای اخیر مرتب عوض شده و تبدیلِ آن به تومان با نرخِ حدسی درست نیست؛ برای همین در این نوشته عددِ تومانیِ ثابت نمینویسیم. در هوشنو هزینهی هر ساخت پیش از شروع در خودِ ابزار نشان داده میشود و پرداخت تومانی و بهاندازهی مصرف است.
| مدل | هزینه معمولاً بسته به | نکته برای صرفهجویی |
|---|---|---|
| مدلهای عکسِ سریع | تعداد تصویر و کیفیت | برای پیشنویس کیفیت پایین بسازید |
| مدلهای عکسِ دقیق و متنی | وضوح و تعداد تکرار | فقط نسخهی نهایی را در این مدل بسازید |
| مدلهای ویدیو | هر ثانیه، وضوح و وجود صدا | اول بیصدا و کوتاه تست کنید |
| ویدیوی با صدا | معمولاً گرانتر از بیصدا | صدا را فقط برای نسخهی نهایی روشن کنید |
فرمولِ سادهی مقایسه: هزینهی واقعی = هزینهی هر ساخت × تعدادِ تکرار تا رسیدن به خروجیِ قابلقبول. مدلی که اولین یا دومین بار جواب میدهد، حتی اگر گرانتر باشد، ارزانتر تمام میشود. در هوشنو اگر ساخت ناموفق شود، اعتبار خودکار برمیگردد.
مقایسههای دوبهدو
برای تصمیمهای ریزتر، این مقایسههای تخصصی را ببینید:
- Midjourney در برابر DALL-E و Stable Diffusion برای تصویرسازها
- Kling در برابر Sora و Runway برای ویدیو
- Veo در برابر رقبا برای کسانی که Veo را در نظر دارند
پرسشِ پرتکرارِ «Veo یا Kling یا Sora» جواب واحد ندارد: Veo برای واقعگرایی و صدا، Kling برای حرکت و عکسِ ورودی و Sora برای روایتِ چندصحنهای معمولاً پیشنهاد میشود. Sora در هوشنو موجود نیست و این نوشته آن را فقط از نظر مقایسهی عمومی میآورد.
چطور خودتان امتحان کنید
بهترین مقایسه همان است که با موضوع و پرامپتِ خودتان انجام میدهید. این مراحل حدود نیم ساعت طول میکشد:
- یک موضوعِ واقعیِ کارتان را انتخاب کنید، مثل عکسِ محصول یا ویدیوی معرفی.
- پرامپتِ عکس را در دو یا سه مدل در ابزار ساخت عکس بدهید و خروجیها را کنار هم بگذارید.
- بهترین عکس را به تصویر به تصویر یا ویرایشگر ببرید و اصلاحش کنید.
- همان عکس را در ابزار ویدیو با دو مدل به ویدیو تبدیل کنید.
- هزینهی نشاندادهشده و کیفیت را بنویسید و مدلِ مناسبتر را انتخاب کنید.
اگر هنوز پرامپتِ ویدیو برایتان سخت است، از چت هوشنو بخواهید پرامپتِ انگلیسیِ دقیق بنویسد. برای ایدهی ویدیو هم ساخت ویدیو با هوش مصنوعی ایرانی را ببینید.
شش پرامپت ویدیو برای آزمون کنار هم
برای ویدیو هم همان منطق را دنبال کنید. این شش پرامپت هر کدام یک ضعفِ رایجِ مدلها را میسنجند. آنها را بدونِ تغییر در هر مدل بدهید و نتیجه را با هم مقایسه کنید.
۱. حرکت دوربین: A smooth tracking shot following a bicycle along a quiet seaside road at sunset, camera moving left to right, 6 seconds.
۲. فیزیک: A glass of water tipping over on a wooden table, water spreading and dripping off the edge, close-up, natural light.
۳. گفتار: A fictional shopkeeper in a small tea shop says a short greeting to the camera, lips synced to speech, warm indoor light.
۴. عکس به ویدیو: Using a still photo of a coffee cup, add gentle rising steam and a slow push-in, keep the cup unchanged.
۵. چندنفره: Three fictional friends laugh around a picnic blanket in a park, handheld camera, afternoon light.
۶. ثبات: The same fictional woman in a red scarf walks through a market, turns her head, and smiles; keep her face and scarf consistent.
در نتیجهی این شش آزمون معمولاً الگوی روشنی دیده میشود: بعضی مدلها در حرکت و فیزیک عالیاند ولی در گفتار میلنگند و بعضی برعکس. بر اساس همین الگو میفهمید برای کارِ خودتان کدام را نگه دارید. اگر ویدیوی شما اصلاً آدم ندارد، آزمونهای سوم، پنجم و ششم برایتان اهمیتی ندارند و میتوانید روی حرکت و فیزیک تمرکز کنید.
یک نکته دربارهی فیزیک: ریختن مایع، حرکتِ پارچه و تماسِ دست با اشیا از سختترین صحنهها هستند. اگر مدلی اینها را خوب درمیآورد، در بقیهی صحنهها هم معمولاً قابلاعتماد است. در مقابل، چهرهی نزدیک و گفتار به جزئیاتی نیاز دارند که با عکسِ مرجع بهتر میشود، پس همیشه در این آزمونها یک عکسِ مرجع هم امتحان کنید و ببینید ثبات چقدر بالا میرود.
کدام مدل را انتخاب کنیم؟ بر اساس نوع کاربر
انتخابِ مدل به شغل و هدف شما بستگی دارد. این پیشنهادها قاعدهی کلیاند و با آزمونِ خودتان باید تأیید شوند.
فروشندهی آنلاین و صاحب فروشگاه اینستاگرامی
برای عکسِ محصول، ثباتِ شکلِ جنس بین چند عکس مهم است. Nano Banana Pro یا GPT Image برای عکسِ محصول و ویرایشِ پسزمینه گزینههای خوبیاند. بعد همان عکس را با Kling یا Veo به ویدیوی کوتاهِ ریلز تبدیل کنید. یک پیشنهاد عملی: اول عکسِ نهایی را بسازید و فقط وقتی راضی شدید سراغ ویدیو بروید، چون ویدیو گرانتر است.
طراح و تصویرساز
برای ایدهپردازی و موودبورد Midjourney معمولاً الهامبخشتر است و Flux کنترل بیشتری میدهد. وقتی طرحِ نهایی متن دارد، آن را در GPT Image بسازید یا متن را در ابزارِ طراحی اضافه کنید.
تولیدکنندهی محتوا و ریلزساز
کلیپهای کوتاه با Kling و Seedance معمولاً سریع و جذاب درمیآیند. اگر صدا و لبخوانی مهم است Seedance یا Veo را امتحان کنید. برای دیدنِ نمونهی ایدهها ترندهای هوشنو را ببینید؛ عکسِ خودتان را میگذارید و ویدیوی ترند را میگیرید.
دانشجو و کسی که تازه شروع کرده
با مدلهای سریع و ارزان شروع کنید. Flux یا Pixverse برای تمرین پرامپتنویسی کافیاند و هزینهی اشتباه کم است. بعد که پرامپتتان جا افتاد، سراغ مدلهای دقیقتر بروید.
اشتباههای رایج در مقایسهی مدلها
بیشترِ مقایسههای آنلاین بهخاطر چند اشتباهِ تکراری گمراهکننده میشوند. اگر خودتان مقایسه میکنید، از اینها دوری کنید:
- مقایسه با پرامپتهای متفاوت: وقتی هر مدل پرامپتِ جدا بگیرد، نتیجه قابلمقایسه نیست.
- قضاوت با یک خروجی: هر مدل گاهی خروجیِ شانسی عالی یا افتضاح میدهد. دستکم سه بار تکرار کنید.
- نادیدهگرفتن هزینه: زیباترین خروجی اگر پنج برابر گران باشد، همیشه بهترین انتخاب نیست.
- مقایسهی نسخههای متفاوت: نسخهی رایگان یا سریعِ یک مدل را با نسخهی حرفهای رقیب کنار هم نگذارید.
- باور به فهرستهای بدونِ تاریخ: مدلها هر چند ماه یکبار عوض میشوند. هر مقایسهای که تاریخ ندارد، شکبرانگیز است.
همینجا یک نکتهی ایمنی هم لازم است: برای عکس و ویدیو از چهرهی کسِ دیگر بدونِ رضایتش استفاده نکنید. فقط از عکسِ خودتان یا شخصیتهای خیالی استفاده کنید و ویدیوی ساختهشده را بهعنوانِ واقعیت منتشر نکنید.
نکتههایی برای نتیجهی بهتر در همهی مدلها
چند عادت، کیفیتِ خروجی را در هر مدلی بالا میبرد. اینها از مستنداتِ سازندگان و تجربهی عمومیِ کاربران جمع شدهاند:
- پرامپت را با سوژه شروع کنید، بعد صحنه، بعد نور و سبک. ترتیبِ واضح به مدل کمک میکند.
- برای ویدیو فقط یک حرکتِ اصلی بخواهید. پرامپتی که پنج حرکتِ همزمان میخواهد معمولاً خراب درمیآید.
- برای ثباتِ چهره، همیشه از یک عکسِ مرجعِ یکسان استفاده کنید و ظاهرِ شخصیت را در هر پرامپت دقیقاً تکرار کنید.
- پرامپتِ انگلیسی معمولاً نتیجهی قابلپیشبینیتری از فارسی میدهد؛ اگر انگلیسیتان قوی نیست، از چت بخواهید ترجمه و بهینهاش کند.
- ابتدا کوتاه و با کیفیتِ پایین تست کنید، بعد نسخهی نهایی را بگیرید.
- خروجیها را با نامِ مدل و پرامپت یادداشت کنید تا بعداً بتوانید بهترینها را تکرار کنید.
برای پرامپتهای آمادهتر هم راهنمای پرامپت برای تصویر و پرامپتنویسی Kling را ببینید.
ویدیوی کوتاه یا عکسِ ثابت؟ کدام را بسازیم
بسیاری از کارها نیازی به ویدیو ندارند. عکسِ ثابتِ باکیفیت ارزانتر است، سریعتر ساخته میشود و راحتتر میشود اصلاحش کرد. ویدیو وقتی میارزد که حرکت پیام را میرساند، مثلاً نمایشِ استفاده از محصول، معرفیِ یک مکان یا تیزرِ کوتاه. روشی که بسیاری از تولیدکنندهها پیش میگیرند این است که اول چند عکسِ ایده را بسازند، بهترین را انتخاب کنند و فقط همان را متحرک کنند. این کار هزینهی آزمونوخطا را بهشدت کم میکند، چون اشتباههای ترکیببندی و رنگ را همان مرحلهی عکس میفهمید.
اگر ویدیو را مستقیم از متن میسازید، پرامپتِ سادهتر و کوتاهتر بنویسید و چند نسخه بگیرید. اگر از عکس میسازید، حرکت را در پرامپت توصیف کنید، مثلاً «دوربین آرام جلو میآید» یا «بخار از فنجان بالا میرود». مدلها معمولاً عکسِ ورودی را حفظ میکنند و فقط حرکت را اضافه میکنند، برای همین ثباتِ بیشتری دارند.
سؤالات متداول
بهترین مدل هوش مصنوعی برای ساخت ویدیو کدام است؟
جواب واحدی وجود ندارد. Veo 3.1 معمولاً برای واقعگرایی و صدا، Kling برای حرکت و عکسِ ورودی و Seedance برای هماهنگیِ لب و صحنههای آدممحور پیشنهاد میشود. بهترین راه این است که با پرامپتِ خودتان دو مدل را امتحان کنید و هزینه را هم بسنجید.
کدام مدل متن فارسی را روی عکس درست مینویسد؟
هیچ مدلی همیشه بیخطا نیست، ولی مدلهایی مثل GPT Image در متن معمولاً بهتر ارزیابی میشوند. متن را کوتاه و داخل گیومه بنویسید، خروجی را حرفبهحرف بخوانید و برای متنِ مهم از افزودنِ متن در ویرایشگر استفاده کنید.
Veo بهتر است یا Kling؟
بستگی به کار دارد. Veo در واقعگرایی و تولید صدا قوی است و Kling در حرکتِ نرم و ساخت از روی عکس. اگر ویدیوی سینمایی با صدا میخواهید Veo، و اگر عکسِ محصول را متحرک میکنید Kling را اول امتحان کنید.
Nano Banana بهتر است یا Midjourney؟
برای ویرایش، ثبات سوژه و عکسِ محصول معمولاً Nano Banana Pro و برای حالِوهوای هنری و ترکیببندی Midjourney پیشنهاد میشود. این دو هدفِ متفاوت دارند و اگر کارتان هر دو را میخواهد، میتوانید از هر دو استفاده کنید.
هزینهی ساخت هر ویدیو چقدر است؟
به مدل، طول، وضوح و صدا بستگی دارد و عددِ ثابت ندارد. در هوشنو هزینه پیش از شروع هر ساخت در خودِ ابزار نشان داده میشود، پرداخت تومانی است و اگر ساخت ناموفق شود اعتبار برمیگردد.
جمعبندی
اگر یک قاعده بخواهید: برای متن و دقت GPT Image، برای هنر Midjourney، برای ویرایش Nano Banana Pro، برای ویدیوی واقعگرا Veo، برای حرکت Kling و برای گفتار و لب Seedance. اما قاعدهی مهمتر این است که مدل را با خروجیِ خودتان بسنجید و هزینهی کلِ تکرارها را حساب کنید.
قدم بعدی ساده است: یک پرامپت بردارید و در چند مدل امتحانش کنید. همهی این کارها را میتوانید یکجا در ساخت ویدیو در هوشنو انجام دهید و برای شناخت بهتر پلتفرم، هوش مصنوعی ایرانی هوشنو را ببینید. برای شروعِ کلیتر هم هوش مصنوعی چیست؟ را بخوانید.