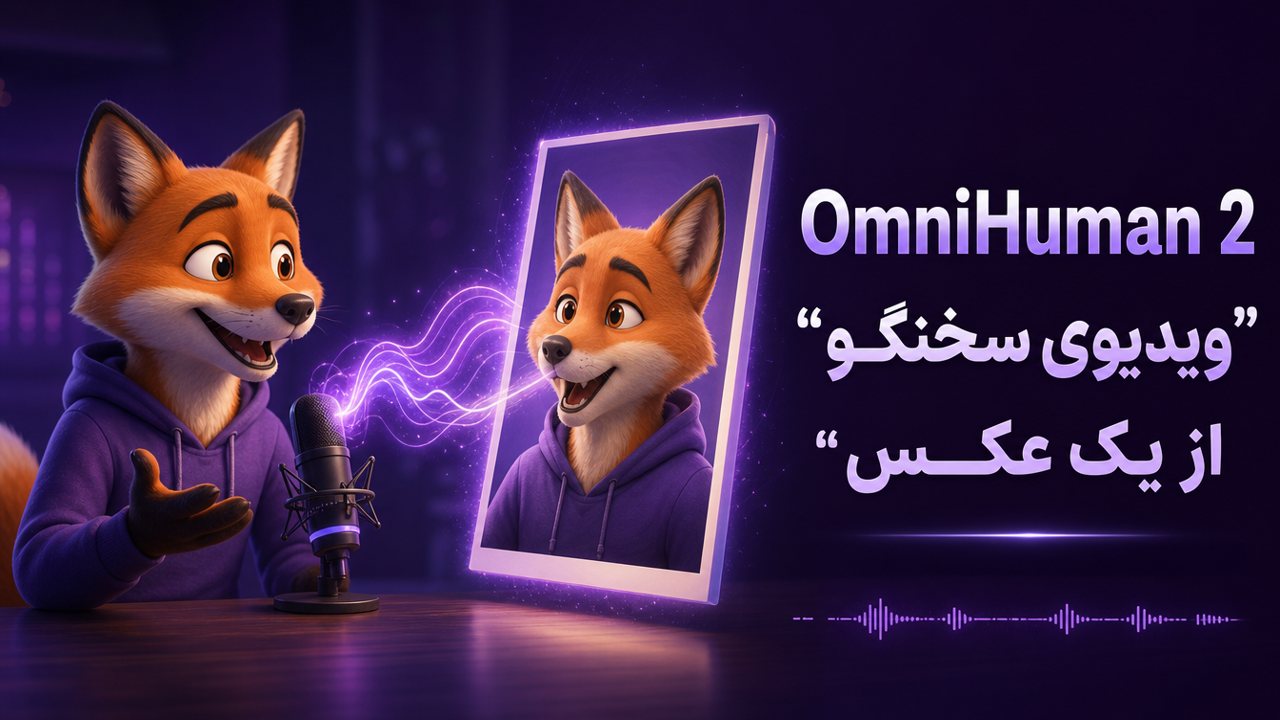
OmniHuman 2 مدلی از شرکت ByteDance است که با یک عکس و یک فایل صدا، ویدیوی سخنگو میسازد؛ شخصیتِ عکس همان صدا را با حرکت لب، حالت چهره و حرکت دست اجرا میکند. شرکت BytePlus این مدل را ۱۵ اکتبر ۲۰۲۶ (۲۳ مهر ۱۴۰۵) عرضه کرد. بزرگترین تغییرش این است که حالا یک ویدیوی پیوسته تا پنج دقیقه میسازد، در حالی که نسخهی قبلی حدود یک دقیقه بود.
این مدل در هوش مصنوعی آنلاین فارسی هوش نو هم در منوی «مدلهای هوش مصنوعی» و در دستهی لبخوانی در دسترس است. در ادامه میخوانید چه میکند، با نسخهی قبلی چه فرقی دارد، چه ضعفهایی دارد و چطور با پرامپتهای درست از آن نتیجه بگیرید. اگر بیشتر دنبال ویدیوی سینمایی از روی متن هستید، مقالهی مقایسهی Veo، Kling و Seedance به کارتان میآید.
OmniHuman 2 چه کارهایی میکند؟
OmniHuman 2 یک «مدل آواتار» است: یک تصویر مرجع و یک صدا میگیرد و اجرای آن صدا را روی شخصیتِ تصویر میسازد. به گفتهی BytePlus، مدل فقط لب را با صدا هماهنگ نمیکند، بلکه لحن، احساس و معنی حرفها را هم میخواند و حرکت چهره و بدن را با آنها هماهنگ میکند.
- ورودی: یک عکس مرجع، یک فایل صدا (گفتار، آواز، موسیقی یا گفتگو) و یک پرامپتِ اختیاری.
- طول: خروجیِ پیوسته از ۳۰ تا ۳۰۰ ثانیه، بدون اینکه ویدیو را تکهتکه بسازید و بچسبانید.
- کیفیت: خروجیِ بومی ۷۲۰p.
- سوژه: آدم، چند نفر در یک صحنه، و حتی شخصیتهای غیرانسانی مثل حیوان، کارتون، انیمه و شخصیتِ سهبعدی.
- پرامپت: برای حرکت دوربین، ژستها، کار با اشیا و کارهایی که با حرفها هماهنگ است.
چند کاربردِ واقعی برای کاربر ایرانی
- ریلز و استوری اینستاگرام: یک شخصیتِ برند یا ماسکوتِ فروشگاه را که از قبل طراحی کردهاید، برای هر پست حرف بزنید و بدون جلوی دوربین رفتن محتوا بسازید.
- تبلیغِ فروشگاه: معرفیِ محصول با یک گویندهی ثابت. صدا را با ابزار گویندگی فارسی میسازید و به مدل میدهید.
- درس و آموزش: مدرس یا شخصیتِ کارتونیِ دوره که درس را تا پنج دقیقه در یک برش توضیح میدهد.
- ویدیوی موزیکال: یک عکس و یک آهنگ؛ خواننده روی صحنه اجرا میکند.
- پادکستِ تصویری: دو شخصیت که گفتگو میکنند، در صحنهی دو نفرهای که از قبل ساختهاید.
اگر فقط یک عکس دارید و میخواهید آن را متحرک کنید ولی صدا ندارید، تبدیل عکس به ویدیو با هوش مصنوعی گزینهی سادهتری است.
OmniHuman 2 چه فرقی با نسخهی قبلی و ابزارهای دیگر دارد؟
فرق اصلی در طولِ ویدیو و قیمتِ هر ثانیه است. جدول زیر فقط چیزهایی را آورده که منبعهای رسمی یا معتبر نوشتهاند.
| ویژگی | OmniHuman 1.5 | OmniHuman 2 |
|---|---|---|
| بیشینهی طولِ ویدیو | حدود ۶۰ ثانیه | تا ۳۰۰ ثانیه (پنج دقیقه) در یک برش |
| قیمتِ رسمی هر ثانیه | ۰٫۱۲ دلار | ۰٫۰۷ دلار |
| کیفیتِ خروجی | گزینهی ۱۰۸۰p در برخی APIها | بومی ۷۲۰p |
| ورودی | عکس، صدا، پرامپت | عکس، صدا، پرامپت |
| صحنهی چندنفره | دارد | دارد، با تمرکز بر هماهنگیِ حرکت و معنیِ صدا |
نتیجهی جدول: اگر ویدیوی بلند میخواهید، نسخهی ۲ بهصرفهتر و سادهتر است. اگر کیفیتِ ۱۰۸۰p لازم دارید، باید خروجی را جداگانه بزرگتر کنید. قیمتِ BytePlus برای هر ثانیه ۰٫۰۷ دلار است (آخرین بررسی: ۸ آبان ۱۴۰۵) و یک برش پنجدقیقهای حدود ۲۱ دلار هزینه دارد.
دربارهی رقبا هم یک تفاوتِ مهم هست: OmniHuman از یک عکسِ ثابت اجرا میسازد، پس با ابزارهای ویرایشِ ویدیوی موجود (که فقط صدای ویدیوی آماده را عوض میکنند) یک کار نیست. مدلهای متنبهویدیو مثل PixVerse V6 Max یا Kling 4.0 هم صحنه میسازند، نه یک شخصیتِ ثابت که دقیقاً با صدای شما حرف بزند. بسته به کارتان باید یکی را انتخاب کنید یا ترکیب کنید.
نقطهضعفها و محدودیتهای OmniHuman 2
- سقفِ ۷۲۰p: برای چاپ یا نمایشگرِ بزرگ باید بعداً کیفیت را بالا ببرید.
- جابهجاییِ پسزمینه: در بررسیهای اولیه، در ویدیوهای بلند گاهی عناصرِ پسزمینه کمی جابهجا میشوند.
- همگامیِ لب: از نزدیک ممکن است بعضی آواها با شکلِ دهان نخواند.
- کیفیتِ صدا مهم است: صدای یکنواخت یا شتابزده به مدل مواد کمتری میدهد؛ صدای زنده و واضح نتیجهی بهتری میدهد.
- زبانِ صدا: BytePlus فهرستِ زبانهای پشتیبانیشده را منتشر نکرده. پیش از پروژهی بزرگ یک نمونهی ۳۰ ثانیهای با صدای فارسیِ خودتان بسازید و ببینید لبها چقدر خوب میخواند.
- مدل فقط آواتار است: برای ساختنِ صحنه یا برشهای سینمایی ساخته نشده.
یک نکتهی اخلاقی هم هست: ساختنِ ویدیو از عکسِ آدمِ واقعی فقط وقتی درست است که خودش رضایت داده باشد. از عکس و صدای دیگران بدون اجازه استفاده نکنید.
چطور OmniHuman 2 را امتحان کنم؟
مدل از طریق API و کنسولِ BytePlus عرضه شده و در هوش نو هم در دسترس است. مراحل در هوش نو:
- به ابزار ساخت ویدیو با هوش مصنوعی بروید و مدل OmniHuman 2 را از منوی مدلها انتخاب کنید.
- عکسِ مرجع را بارگذاری کنید. چهرهی واضح و نورِ خوب بهتر کار میکند.
- فایلِ صدا را اضافه کنید (WAV یا MP3). اگر صدا ندارید، اول با ابزار گویندگی بسازید.
- در صورت نیاز یک پرامپتِ کوتاه برای حرکت و دوربین بنویسید.
- قیمت را که پیش از ساخت زیرِ دکمهی ساختن نشان داده میشود ببینید و بسازید.
قیمتِ دقیق پیش از ساخت، زیرِ دکمهی ساختن نشان داده میشود. هزینه به طولِ صدا بستگی دارد، پس برای آزمایش با صدای کوتاه شروع کنید.
نوشتنِ پرامپتِ خوب برای OmniHuman 2
عکس چهره و اتاق را مشخص میکند، پس در پرامپت چهره را دوباره توضیح ندهید. فقط رفتار را بگویید: ژست، حرکتِ دست، دوربین و کار با اشیا. پرامپتها را به انگلیسی بنویسید تا مطمئنتر باشد.
The presenter speaks warmly to the camera, uses small natural hand gestures, slow push-in camera, steady framing.
She holds up the product with one hand while talking, then points to it. Camera stays still, soft smile between sentences.
The singer performs on stage, eyes closed on the long notes, one hand on the microphone, gentle handheld camera.
Two characters at a table: the man speaks, the woman listens and nods, then reacts with a laugh. Locked-off wide shot.
The cartoon fox explains the lesson with big expressive gestures, tilts its head on questions, camera slowly moves to a close-up.
برای صحنهی چندنفره، اول عکسِ شروع را با یک مدل تصویر بسازید و بعد در پرامپت بگویید هر کس چه واکنشی نشان دهد. برای ساختنِ عکسِ مرجع از ابزار ساخت عکس استفاده کنید.
سؤالات متداول
OmniHuman 2 چیست؟
OmniHuman 2 مدلِ ویدیوی آواتارِ شرکت ByteDance است که با یک عکس و یک فایل صدا، ویدیوی سخنگو میسازد. شخصیت با همان صدا لب میزند و حالت چهره و حرکتِ دست دارد. BytePlus آن را ۱۵ اکتبر ۲۰۲۶ عرضه کرد.
OmniHuman 2 تا چند دقیقه ویدیو میسازد؟
تا پنج دقیقه در یک برشِ پیوسته. خروجی بین ۳۰ تا ۳۰۰ ثانیه است و لازم نیست ویدیو را تکهتکه بسازید و بچسبانید. نسخهی قبلی حدود یک دقیقه بود.
قیمتِ OmniHuman 2 چقدر است؟
BytePlus قیمتِ رسمی را ۰٫۰۷ دلار برای هر ثانیه اعلام کرده؛ یعنی یک ویدیوی ۱۵ ثانیهای حدود یک دلار و پنج دقیقه حدود ۲۱ دلار (آخرین بررسی: ۸ آبان ۱۴۰۵). قیمتِ دقیق پیش از ساخت، زیرِ دکمهی ساختن نشان داده میشود.
آیا OmniHuman 2 فارسی را میفهمد؟
نمیتوان با قطعیت گفت. BytePlus فهرستِ زبانهای صدا را منتشر نکرده است. مدل بیشتر لحن و ریتمِ صدا را دنبال میکند، ولی بهتر است پیش از پروژهی بزرگ یک نمونهی کوتاه با صدای فارسیِ خودتان بسازید.
آیا میشود با عکسِ کارتونی یا حیوان هم ویدیو ساخت؟
بله. به گفتهی منبعهای معتبر، مدل علاوه بر آدم، حیوان، کارتون، انیمه و شخصیتِ سهبعدی را هم پشتیبانی میکند. این برای ماسکوتِ برند و آموزش کودک کاربرد زیادی دارد.