گزارشِ تازهی Vercel که ۲۳ مهر ۱۴۰۵ (۱۵ اکتبر ۲۰۲۶) منتشر شد نشان میدهد مدلِ Jev از شرکتِ TypeSafe AI در دو هفتهی اول به ۳۵٫۳ درصد از تیمهای پولیِ AI Gateway رسیده است؛ تقریباً دو برابرِ Claude Sonnet 5.5 که با ۱۸٫۱ درصد دوم شد. Vercel این را سریعترین پذیرشِ یک مدل در تاریخِ دروازهاش مینامد. TechCrunch هم ۲۴ مهر (۱۶ اکتبر) همین خبر را پوشش داد.
Jev چیست و چرا مدلِ «متفاوتی» است؟
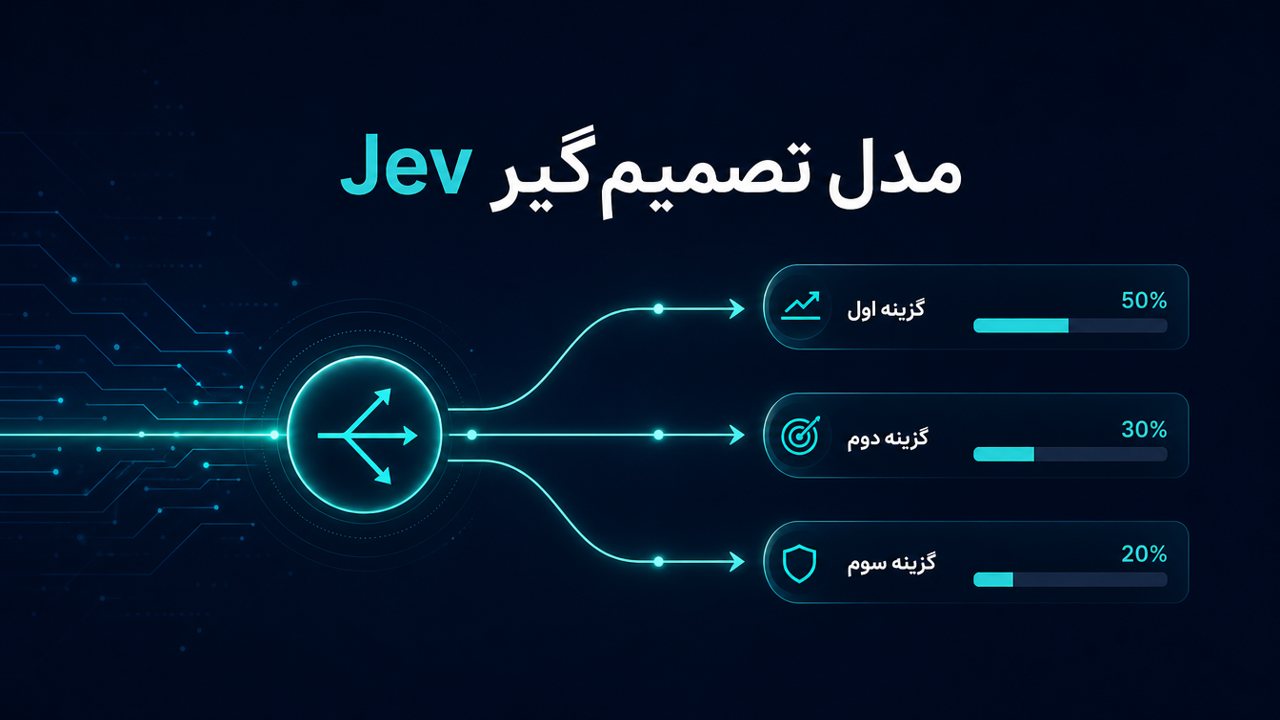
Jev یک مدلِ زبانیِ گفتوگومحور نیست. TypeSafe آن را «مدلِ تصمیمگیر» مینامد: تو فهرستی از پاسخهای ممکن را از پیش مشخص میکنی، مثلاً «خطرناک» یا «بیخطر»، و Jev یکی از آنها را همراه با یک احتمال برمیگرداند. چون خروجی محدود است، طبق گزارشِ TechCrunch از مدلهای همهمنظوره ارزانتر و سریعتر است و برای دستهبندیِ حجمهای زیادِ داده مناسب است. بنیانگذارش دیوگو آلمیدا، پژوهشگرِ پیشینِ OpenAI است که در ساختِ ChatGPT نقش داشته و از مخترعانِ روشِ RLHF شمرده میشود. به گفتهی خودِ شرکت مدل فقط با دادهی ساختگی آموزش دیده؛ معماریاش منتشر نشده است.
اعداد گزارشِ Vercel
- Jev ۱۷ سپتامبر (۲۶ شهریور) روی AI Gateway آمد.
- ۵۵٫۶ درصد از تیمهایی که در هفتهی اول امتحانش کردند، هفتهی بعد هم برگشتند.
- با اینکه نیمهی ماه عرضه شد، در سپتامبر بیشترین درخواست را از میانِ همهی مدلها گرفت.
- سهمش از کلِ توکنها حدود ۱ درصد و از هزینه کمتر از ۰٫۳ درصد بود؛ یعنی پرکاربرد ولی ارزان.
- Claude Opus 5.5 با ۱۱٫۰۳ درصدِ هزینه در دو هفتهی اول بزرگترین سهمِ هزینه را در بینِ مدلهای سپتامبر گرفت.
Vercel خودش از اولین کاربرانِ Jev بود و با آن مدلِ GPT-6 Luna را در دستهبندیِ فرمانهای خطرناک عوض کرد. در گزارشها آمده این تغییر نتیجه را ۵ تا ۱۸ برابر سریعتر و دقیقتر کرده؛ این ادعای خودِ Vercel است و آزمونِ مستقل ندارد.
چه چیزهایی را باید با احتیاط خواند؟
دادهها فقط از ترافیکِ Vercel AI Gateway است. TechCrunch یادآوری میکند که این دید ناقص است و ممکن است سهمِ شرکتهایی مثل OpenAI و Anthropic را که API خودشان را دارند کمتر نشان دهد. Vercel هزینه را هم با قیمتِ فهرست تخمین زده، نه صورتحسابِ واقعی. حتی خودِ گزارش سهمِ هزینهی Jev را در بخشهای مختلف سه عددِ کمی متفاوت داده است. در عین حال Jev جواب نمیدهد «چرا»؛ فقط احتمال میدهد. تصمیم دربارهٔ اینکه با یک عدد چه کنیم هنوز با خودِ ماست. به نوشتهی TechCrunch رقبایی مانند OpenAI و آمازون هم نسخههای مشابه آوردهاند.
تصویرِ بزرگتر: متنباز و چینیها
گزارش چند عددِ دیگر هم دارد: مدلهای وزنباز ۷۱٫۵ درصدِ توکنها و حدود ۲۳ درصدِ هزینهی سپتامبر را پردازش کردهاند، در حالی که این سهمِ هزینه در خرداد حدود ۵ درصد بود. مدلهای DeepSeek ۵۸ درصدِ توکنها را بردهاند ولی فقط ۶٫۶ درصدِ هزینه را. سهمِ Anthropic از هزینه از ۶۳٫۷ درصد در مرداد به ۴۳٫۹ درصد در شهریور رسیده است. تقریباً از هر سه تیم یکی در سپتامبر مدلِ اصلیِ خودش را عوض کرده که رکوردی در این گزارش است.
این خبر برای کاربرِ ایرانی و فارسیزبان چه معنایی دارد؟
اگر برنامهنویس یا مدیرِ محصولی، پیام روشن است: همهی کارها به یک مدلِ بزرگ و گران نیاز ندارند. دستهبندی ایمیل، تشخیصِ پیامِ هرز یا مسیردهیِ درخواستها را میشود به مدلی ارزانتر سپرد. مایکروسافت هم چنین مدلی را معرفی کرده است؛ ببین مدل تصمیمگیر ارزان مایکروسافت. برای کارهایی که واقعاً گفتوگو و نوشتن میخواهند، مدلهای عمومی همچنان جای خودشان را دارند؛ مثلاً Claude Sonnet 5.5 و GPT-6.1 Sol را بخوان. این مدلها و چند مدلِ دیگر در ابزارهای هوشنو برای چت به فارسی در دسترساند. دسترسی به سرویسِ Jev در ایران را ما بررسی نکردهایم و دربارهٔ آن چیزی تأیید نمیکنیم.
سؤالات متداول
Jev چیست؟
مدلِ تصمیمگیرِ شرکتِ TypeSafe AI که از میانِ پاسخهای از پیشتعریفشده یکی را با احتمال برمیگرداند و متن نمینویسد.
چطور میشود از آن استفاده کرد؟
طبق منبعها از راهِ Vercel AI Gateway با شناسهی typesafe-ai/jev در دسترس است. قیمتِ دقیق در منبعهای رسمی که دیدیم اعلام نشده بود.
آیا جای ChatGPT یا Claude را میگیرد؟
نه. برای دستهبندی و تصمیمهای ساده ساخته شده، نه برای گفتوگو، نوشتن یا استدلال.