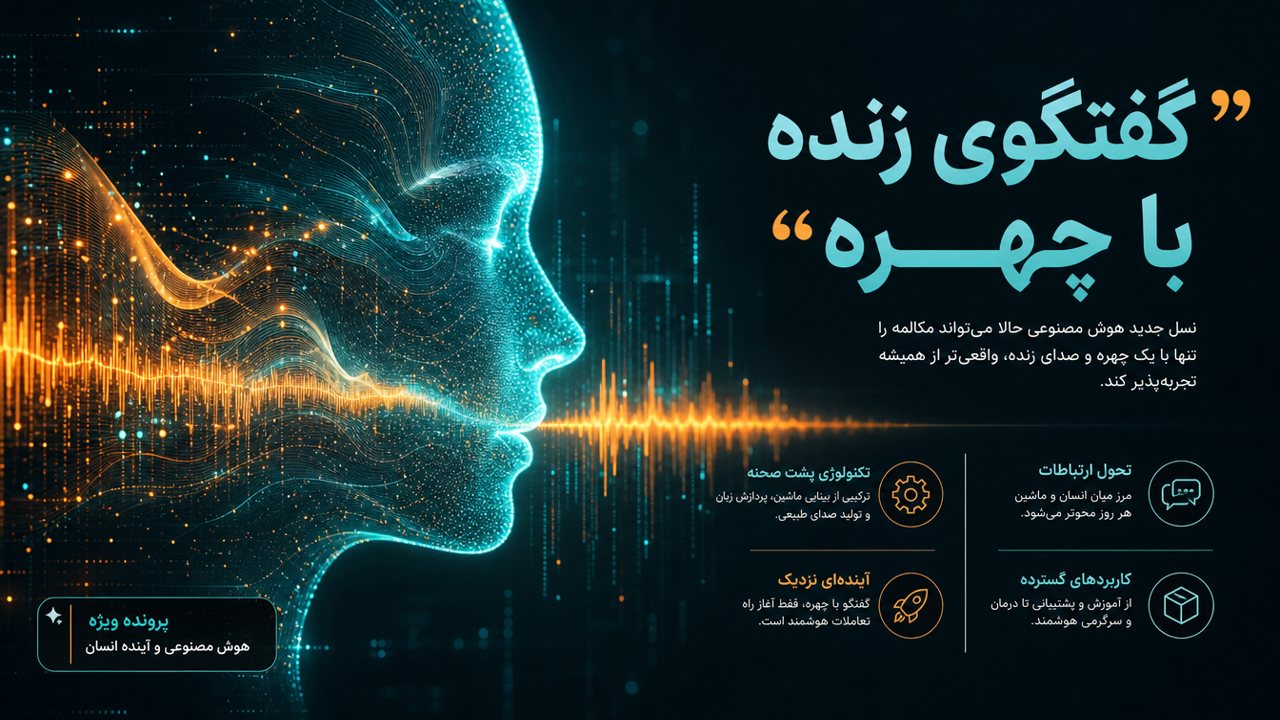
شرکت Boson AI روز ۱۴ آبان ۱۴۰۵ (۵ نوامبر ۲۰۲۶) از «Higgs Realtime Duplex» رونمایی کرد؛ اولین مدلِ چندرسانهایِ «دوطرفهی همزمان» این شرکت که همزمان گوش میدهد، میبیند و حرف میزند و چهرهی خودش را هم دارد. طبق نوشتهی رسمیِ Boson مدل هنوز عمومی نشده و API آن «بهزودی» میآید؛ علاقهمندان میتوانند در فهرست انتظار ثبتنام کنند.
«دوطرفهی همزمان» یعنی چه؟
بیشترِ دستیارهای صوتی نوبتی کار میکنند: شما حرف میزنید، مکث میکنید، مدل جواب میدهد. مدلِ دوطرفه (full-duplex) مثل یک گفتوگوی انسانی است: همزمان گوش میدهد و میتواند وسطِ حرفِ شما «آهان» بگوید یا ساکت بماند. Boson میگوید مدلش خودش تشخیص میدهد کی باید حرف بزند و حرفهایی را که خطاب به او نیست نادیده میگیرد. کارش در قطعههای ۱۶۰ میلیثانیهای انجام میشود، یعنی کمتر از یکششمِ ثانیه.
مشخصات اعلامشده
- اندازه: مدلِ جلویی از نوع MoE با ۴۵ میلیارد پارامتر.
- آموزش: حدود ۲ تریلیون توکنِ متن، صدا و ویدیو.
- ابزار و تفویض: مدل در حینِ گفتوگو فکر میکند، ابزار صدا میزند و کارهای سنگین را به یک مدلِ بزرگترِ پشتیبان میسپارد، بیآنکه گفتوگو قطع شود.
- صدا و چهره: هر دو با یک کلیپِ مرجع و یک عکس، بدونِ آموزشِ جداگانه (zero-shot) تنظیم میشوند.
عددهای آزمون
| آزمون | امتیاز | جایگاه طبق شرکت |
|---|---|---|
| Big Bench Audio | ۹۸٫۹ | بالاترین |
| Audio MultiChallenge APR | ۴۴٫۹ | دوم |
| Full-Duplex-Bench v1.5 | ۷۵٫۵ | پشتِ TML (۷۷٫۸) و GPT-Live-1 (۸۰٫۱) |
| ProactiveVideoQA PAUC | ۳۱٫۹ | دوم |
| τ-Voice (تکمیل کار) | ۶۹٫۸ | دوم |
| IFEval (پیروی از دستور) | ۹۴٫۱ | دوم |
خودِ شرکت مینویسد نتیجهها با رقبا «بالا و پایین» دارند؛ یعنی در چند آزمون برنده است و در چند آزمون عقبتر. امتیازِ رقبا هم از گزارشهای منتشرشدهی خودشان برداشته شده، نه از اجرای مستقل.
قیمت و دسترسی
قیمتی برای Duplex اعلام نشده. Boson فقط میگوید هدفش این است که یک ساعت استفاده از مدل حداکثر یکدهمِ هزینهی یک ساعت کارِ انسان باشد. نسخهی قبلی، Higgs Realtime که خروجیِ آواتار دارد، همین حالا در دسترس است و نرخش در صفحهی قیمتگذاریِ شرکت آمده.
جای این مدل در رقابتِ صدا
گفتوگوی زندهی صوتی و تصویری میدان رقابتِ بزرگهاست. متا بهتازگی به Muse صدا و آواتار داد که در Muse متا حالا صدا و چهره دارد بررسی کردهایم، و در حوزهی مدلهای کوچکِ گویندگی هم Woof را معرفی کردهایم. تفاوتِ Duplex این است که بهجای زنجیرهی «تبدیل صدا به متن، فکر، تبدیل متن به صدا»، یک مدلِ یکپارچه است و همین تأخیر را کم میکند.
این یعنی چه برای کاربر فارسیزبان؟
در صفحهی رسمی از پشتیبانیِ فارسی حرفی نیست و مدل هنوز عمومی نشده؛ پس فعلاً نمیتوان آن را امتحان کرد. خبر برای این مهم است که نشان میدهد دستیارهای صوتیِ آینده طبیعیتر و بدونِ نوبتبازی خواهند بود. تا آن زمان، برای گفتوگوی متنی به فارسی، ساخت گویندگی فارسی و کارهای دیگر میتوانید در ابزارهای هوشنو کار کنید. اگر با مفهومِ ایجنت آشنا نیستید، راهنمای ایجنتهای هوش مصنوعی را هم ببینید.
چرا گفتوگوی بینوبت مهم است؟
در تماسِ تلفنیِ واقعی، مکثِ یک ثانیهای هم احساسِ رباتبودن میدهد. وقتی مدل بتواند همزمان بشنود و ببیند، میتواند وسطِ توضیحِ شما بفهمد گیج شدهاید، یا هنگامِ نشاندادنِ چیزی با دوربین، همان لحظه واکنش نشان دهد. کاربردهای محتملش دستیار پشتیبانی، آموزش زبان، شخصیتهای بازی و همراههای گفتوگومحورند. Boson میگوید طراحی را طوری کرده که هزینهی هر ساعت به اندازهای پایین بیاید که استفادهی انبوه از آن بهصرفه باشد؛ ولی تا وقتی نرخ رسمی منتشر نشود، این فقط هدف است.
چه چیزهایی هنوز معلوم نیست؟
- زمان عرضهی API و قیمتِ نهایی.
- زبانهای پشتیبانیشده، بهویژه فارسی.
- آزمونهای مستقل از کیفیتِ چهره و هماهنگی لب.
- مدلِ پشتیبانِ بزرگتری که کارهای سنگین را به آن میسپارد.
سؤالات متداول
Higgs Realtime Duplex چیست؟
مدلی دوطرفهی همزمان که همزمان گوش میدهد، میبیند و با چهرهی خودش حرف میزند.
الان قابلاستفاده است؟
خیر؛ API «بهزودی» میآید و فهرست انتظار دارد.
چند پارامتر دارد؟
مدلِ جلویی ۴۵ میلیارد پارامتر (MoE) است و حدود ۲ تریلیون توکن آموزش دیده.
قیمتش چقدر است؟
هنوز اعلام نشده است.