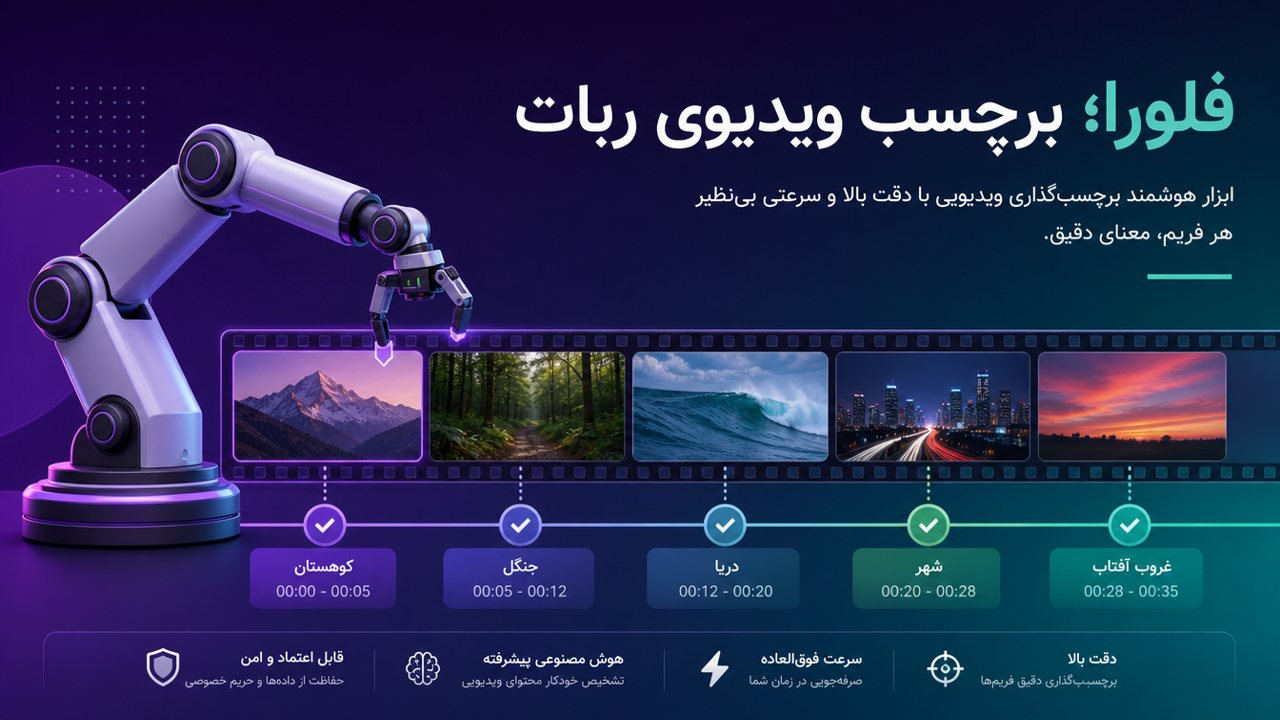
شرکت Nvidia مجموعهی Flora را متنباز کرد؛ موتوری برای برچسبزدن خودکار ویدیوهای آموزش رباتها. Nvidia میگوید این کار تا حدود ۱۲۵ برابر ارزانتر از استفاده از GPT-6 Astra تمام میشود. خبر را The Decoder روز ۳ آبان ۱۴۰۵ (۲۵ اکتبر ۲۰۲۶) منتشر کرد و مدلها در Hugging Face هستند.
Flora چیست؟
برای آموزش رباتها باید ساعتها ویدیو را برچسب زد: کدام حرکت کِی شروع و تمام شد، هر گام چقدر خوب بود، و کار در نهایت موفق شد یا نه. طبق صفحهی پروژهی Nvidia Flora «موتور دادهی» صنعتیای است که برای آموزش مدلهای GR00T استفاده میشود و سه خروجی میدهد: زیرنویس زماندار، برچسب نتیجه و برچسب فرایند. Nvidia میگوید روزانه ۲۰۰ هزار ساعت داده را روی ۵۱۲ پردازندهی GB300 برچسب میزند.
در مجموعهی Hugging Face سه مدل دیده میشود: Flora-Captioner، Flora-TempSeg و Flora-Rewarder. به نوشتهی The Decoder، اینها نسخههای تنظیمشدهی مدلهای Qwen3.5 هستند.
عددها چه میگویند؟
- هزینه: حدود ۰٫۷۲ دلار برای هر ساعت ویدیو، در برابر حدود ۸۸٫۵ دلار برای GPT-6 Astra. این اعداد برآورد است، نه اندازهگیریِ تولید، و اجارهی هر پردازنده را ۱۰ دلار در ساعت فرض کرده.
- کیفیت برچسب: در آزمون ۵۰ ویدیو، Flora امتیاز ۵۷٫۱ درصد گرفت و GPT-6 Astra ۵۳٫۷ درصد.
- پیداکردن گامهای شکستخورده: Flora-Rewarder ۵۳٫۳ درصد از گامهای ناموفق را گرفت؛ هیچ رقیبی از ۱۱٫۷ درصد بالاتر نرفت. در عوض حدود ۱۱ درصد گامهای عادی را هم اشتباهاً خطا نشان داد.
محدودیتها را فراموش نکنید
برتری Flora همهجا نیست. طبق جدول خودِ Nvidia در یکی از آزمونها (WGO-Bench) امتیاز Flora ۶۴٫۷ و GPT-6 Astra ۷۷٫۴ است؛ در بخشهای دیگر هم Astra جلوتر است. Flora گاهی کار طولانی را به گامهای زیادی خرد میکند و گاهی توصیف را غلط مینویسد؛ مثلاً پاککردنِ میز را «تا کردن دستمال» نامیده است. پژوهشگران خودشان هم میگویند GPT-6 Astra هم مدلِ مورد آزمون بوده و هم داورِ توصیفها، که ایرادِ روششناختی است. مجوز مدلها در صفحهها ذکر نشده و پیش از استفادهی تجاری باید جداگانه بررسی شود. تاریخ دقیقِ انتشار هم در صفحهی رسمی نیامده است.
این یعنی چه برای کاربرِ فارسیزبان؟
Flora ابزاری برای پژوهشگران و شرکتهای رباتیک است، نه کاربر عادی. ولی نکتهی بزرگتر این است که مدلهای کوچک و تخصصی در یک کار مشخص میتوانند با بخشی از هزینه به مدلهای بزرگ همگانی نزدیک شوند یا از آنها بهتر باشند. اگر روی دادهی ویدیویی یا برچسبزنی کار میکنید، متنبازبودنِ این مدلها فرصتی برای آزمایش است. برای کار با مدلهای همهمنظوره، به ابزارهای هوشنو سر بزنید. مطلب مرتبط: Flint، مدل کدنویسی ۴۰ میلیاردی برای لپتاپ که همین روند «مدل کوچک و تخصصی» را نشان میدهد.
سؤالات متداول
چرا برچسبزدن ویدیو اینقدر مهم است؟
رباتها مثل مدلهای زبانی از متن یاد نمیگیرند؛ از ویدیوی انسانها و رباتها یاد میگیرند. اما ویدیوی خام بدون برچسب به دردشان نمیخورد: باید معلوم باشد کجا «برداشتن لیوان» شروع شد، کجا گام اشتباه بود و آخرش کار درست انجام شد یا نه. این برچسبزدن تا امروز یا با نیروی انسانی انجام میشد یا با مدلهای بزرگ تجاری که ساعتی دهها دلار هزینه دارند. اگر مدل کوچکی بتواند همین کار را با کیفیتی نزدیک و هزینهای بسیار کمتر انجام دهد، دادهی بیشتری برای آموزش رباتها فراهم میشود. همین روند را در مدلهای متنباز زبانی هم میبینیم، مثل Kimi K3.1 Pro از Moonshot که نزدیک مدلهای بستهی گران آمد.
Flora را همه میتوانند استفاده کنند؟
مدلها در Hugging Face هستند، ولی مجوز در صفحهها آمده نیست. پیش از هر استفادهی تجاری مجوز را بررسی کنید.
واقعاً ۱۲۵ برابر ارزانتر است؟
این رقم برآورد Nvidia با فرض اجارهی پردازنده است و اندازهگیریِ واقعیِ تولید نیست.
Flora به چه دردی میخورد؟
برچسبزدن ویدیوهای رباتها: زیرنویس حرکتها، امتیاز موفقیت و پیداکردن گامهای خراب. خروجی آن دادهی آموزشی برای مدلهای رباتی مثل GR00T است، نه چیزی که کاربر عادی مستقیم ببیند.