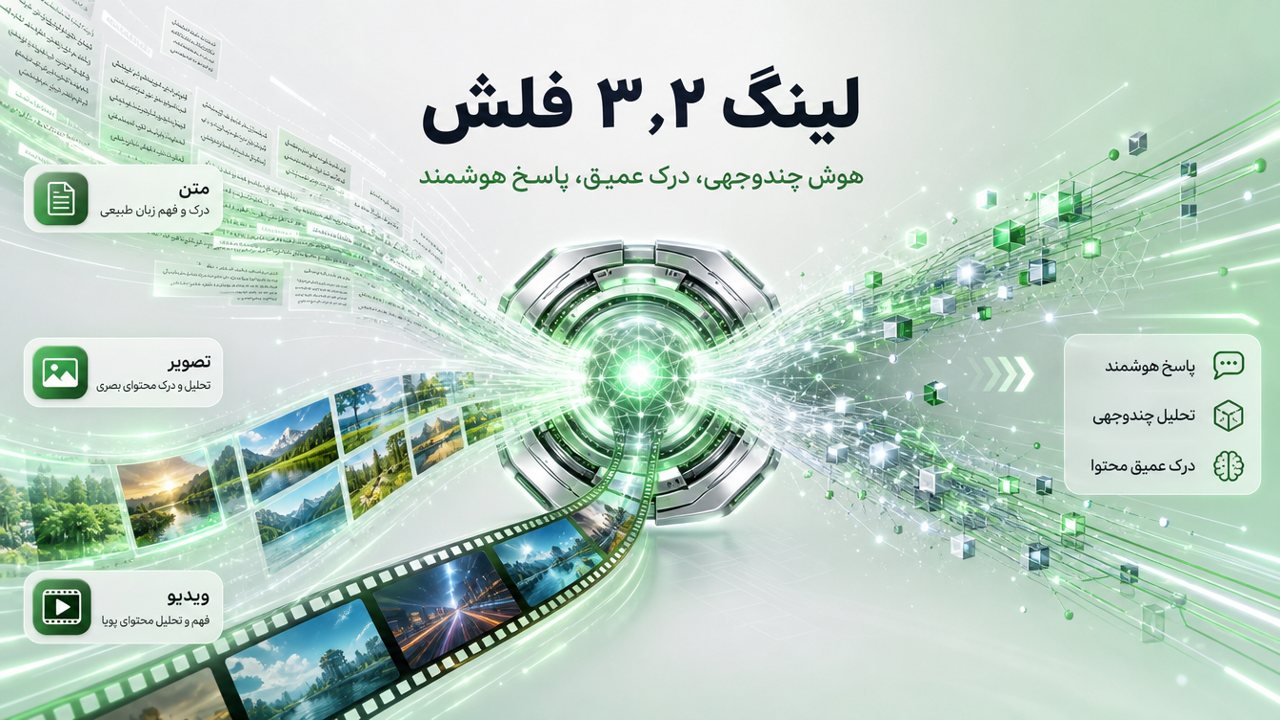
گروه Ant (مورچه) روز پنجشنبه ۱۴ آبان ۱۴۰۵ (۵ نوامبر ۲۰۲۶) مدل «Ling-3.2-flash» را عرضه کرد؛ مدلی چندرسانهای که متن، تصویر و ویدیو را میپذیرد. طبق تغییرنامهی رسمیِ Ant Ling و گزارشِ TechNode مدل ۵۶۰ میلیارد پارامتر دارد که در هر گام فقط ۲۵ میلیارد آن فعال میشود و پنجرهی زمینهاش یک میلیون توکن است. دو هفتهی اول استفاده از آن رایگان است.
مشخصاتِ Ling-3.2-flash
- ساختار: ۵۶۰ میلیارد پارامترِ کل و ۲۵ میلیارد فعال در هر گامِ استنتاج؛ یعنی از ساختارِ «ترکیبِ متخصصها» (MoE) استفاده میکند که در آن فقط بخشی از مدل برای هر توکن کار میکند.
- ورودی: متن، تصویر و ویدیو، بهصورت بومی (نه با چسباندنِ چند مدل).
- زمینه: یک میلیون توکن؛ یعنی میتواند متنهای خیلی بلند را یکجا بخواند.
- تمرکز: فهمِ تصویریِ پیچیده، کارهای چندمرحلهای ایجنتی، فهم و تعاملِ سهبعدی و کاربردهای پزشکیِ چندرسانهای.
- دسترسی: از راهِ رابطِ چتِ اینترنتی و API هایی که با پروتکلهای OpenAI و Anthropic سازگارند.
سازگاری با پروتکلِ OpenAI و Anthropic یعنی چه؟
برنامهنویسی که کدی برای API این دو شرکت نوشته، معمولاً میتواند بدونِ بازنویسیِ زیاد آدرس و کلید را عوض کند و مدلِ Ling را امتحان کند. این روشِ رایجِ مدلهای چینی برای کمکردنِ هزینهی مهاجرت است؛ همین الگو را در DeepSeek V4.1 Flash 1017 و MiniMax M3.1 Flash هم دیدهایم. ولی سازگاریِ پروتکل یعنی قابلیتها و رفتارِ مدل یکی است، نه؛ باید با نمونهی خودتان بسنجید.
«flash» یعنی چه؟
در نامگذاریِ مدلهای هوش مصنوعی، «flash» معمولاً نسخهی سریعتر و ارزانتر است که برای کارهای پرتعداد ساخته میشود. Ant در تغییرنامه نگفته دقیقاً چه چیزی را فدا کرده، پس مقایسهی «flash» با نسخههای بزرگتر را باید با آزمونِ خودتان انجام داد. TechNode هم قیمتِ بعد از دو هفتهی رایگان را ننوشته است. پس اگر میخواهید مدل را در یک محصول بهکار بگیرید، پیش از وابستهشدن به آن، قیمتِ پس از دورهی رایگان و سقفِ تعداد درخواست را از مستنداتِ رسمی بپرسید و گردشِ کارتان را طوری بچینید که بشود مدل را عوض کرد.
این یعنی چه برای کاربر فارسیزبان؟
برای بیشترِ کاربرانِ عادی خبری مستقیم نیست، ولی برای کسی که با API کار میکند دو نکته مهم است. نخست، مدلی با ورودیِ ویدیو و زمینهی یکمیلیونی که فعلاً رایگان آزمایش میشود، فرصتِ ارزانی برای امتحان است؛ مثلاً خلاصهکردنِ یک گزارشِ بلند یا توصیفِ یک ویدیو. دوم، هیچ چیز در منبعها دربارهی کیفیتِ زبان فارسی نیست؛ پیش از هر استفادهی جدی چند متنِ فارسیِ خودتان را بدهید و ببینید. رقیبانِ همین رده را در Kimi K3.1 Pro بخوانید. اگر فقط میخواهید چت کنید یا عکس و ویدیو بسازید، در ابزارهای هوشنو مدلهای آمادهی فارسیپسند هست و لازم نیست API بگیرید.
مدلهای چینی چه میکنند؟
در همین دو روز تنسنت Hy4 را عرضه کرد و Moonshot وزنهای Kimi K3.1 Pro را منتشر کرد، و حالا Ant هم مدلی با زمینهی یک میلیون توکن آورده است. الگو روشن است: زمینهی بسیار بلند، ساختار MoE و ورودیِ چندرسانهای دارد استاندارد میشود و قیمتها پایین میآید. برای دیدنِ بقیهی خبرها به صفحهی اخبارِ هوشِ مصنوعی در وبلاگ سر بزنید.
چه چیزی هنوز معلوم نیست؟
- قیمتِ بعد از دو هفتهی رایگان و محدودیتهای نرخ.
- مجوز و اینکه وزنهای مدل منتشر میشود یا نه؛ در منبعها نیامده.
- نتیجهی آزمونهای مستقل و کیفیتِ فارسی.
- جزئیات «کاربردهای پزشکی» و اینکه برای کارِ بالینی چه تأییدیههایی دارد.
جمعبندی
Ling-3.2-flash یک مدل چندرسانهایِ سریع با زمینهی یک میلیون توکن و دو هفته دسترسیِ رایگان است. اطلاعاتِ منتشرشده فعلاً فقط مشخصات و تمرکزِ شرکت را میگوید؛ ارزشِ واقعیاش را آزمونِ مستقل و تجربهی خودتان روشن میکند.
سؤالات متداول
Ling-3.2-flash چیست؟
مدلِ چندرسانهایِ گروه Ant با ۵۶۰ میلیارد پارامتر (۲۵ میلیارد فعال) که متن، تصویر و ویدیو را میفهمد.
آیا رایگان است؟
دو هفتهی اول پس از عرضه رایگان است؛ قیمتِ بعدش اعلام نشده.
چطور میشود از آن استفاده کرد؟
از راهِ رابطِ چتِ اینترنتی یا API هایی که با پروتکلهای OpenAI و Anthropic سازگارند.